


Olign 1.1 출시, 더 정확해진 단어 타임스탬프
Olign 1.1은 FA-Bench의 모든 테스트 세트에서, 깨끗한 음성에서도 잡음 속에서도 Olign 1.0보다 단어 시간을 더 정확하게 찾습니다. 지금 쓰시는 요청은 그대로 작동합니다.
FA-Bench 리더보드 · github.com/olewave/fa-bench
Olign 1.1이 Olign API에 출시되었습니다. 측정한 모든 테스트 세트에서, 깨끗한 음성이든 잡음이 있는 음성이든 Olign 1.0보다 단어 시간을 더 정확하게 찾습니다.
단어 타이밍이 어긋나면 사람들은 바로 알아챕니다. 자막은 화자가 말을 시작할 때 나타나고 말을 마칠 때 사라져야 합니다. 더빙은 쉼에서 음성을 대사 단위로 나누므로, 각 쉼은 실제 위치에 있어야 합니다. 언어 학습 앱은 각 단어가 소리 나는 순간에 그 단어를 강조해야 합니다. 모두 100분의 몇 초 차이로 갈립니다.
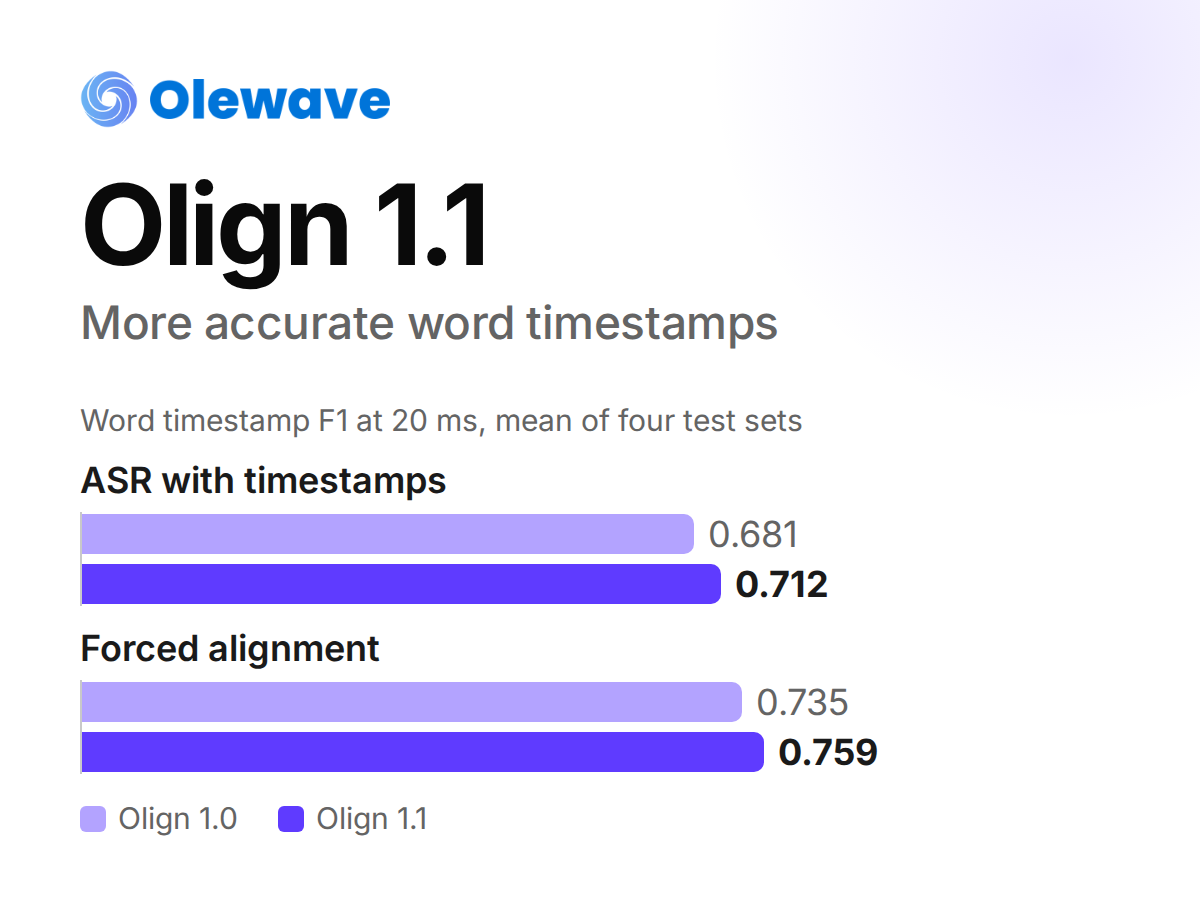
Olign 1.1은 단어 시간을 실제 음성에 더 가깝게 맞추고, 이제 쉼도 실제 길이에 가깝게 돌려줍니다. FA-Bench 네 개 테스트 세트의 평균으로, 20 ms 기준 단어 타임스탬프 F1은 오디오만 있을 때 0.681에서 0.712로, 전사문이 있을 때 0.735에서 0.759로 올랐습니다. 지금 쓰시는 요청은 그대로 작동합니다.
측정 방법
2026년 11월에 실서비스에서 측정한 Olign 릴리스 1.1.3과 2026년 10월에 측정한 Olign 1.0을 비교했습니다. 둘 다 같은 테스트 세트에서 실행했고, 같은 공개 FA-Bench 채점기로 채점했습니다.
FA-Bench는 단어와 음소 경계를 사람이 직접 라벨링한 두 영어 코퍼스를 사용합니다. TIMIT core test는 낭독 음성이고, Buckeye test는 대화 음성입니다. 각각 깨끗한 음성으로, 그리고 잔향, 잡음, 음악, 여러 사람의 말소리를 더한 음성으로 실행합니다. 아래의 '잡음 음성'은 이 네 가지의 평균입니다. 그래서 테스트 세트는 네 개가 되고, '4개 평균'은 그 평균입니다.
트랙은 두 가지입니다. 타임스탬프가 있는 ASR은 오디오만 받고, Olign이 직접 인식한 단어를 시간과 함께 돌려줍니다. 강제 정렬은 전사문도 함께 받습니다.
20 ms 기준 단어 타임스탬프 F1은 단어의 시작 시간과 끝 시간 가운데 사람이 붙인 라벨로부터 20 ms 안에 들어오는 비율을, 정밀도와 재현율을 합쳐 나타낸 값입니다. 높을수록 좋습니다.
단어 오류율은 바뀌거나 빠지거나 더해진 단어를 세어, 실제로 말한 단어 수에 대한 비율로 나타냅니다. 낮을수록 좋습니다.
단어 경계 오차는 Olign의 단어 경계와 사람이 라벨링한 경계 사이의 평균 거리이며, 단위는 밀리초입니다. 낮을수록 좋습니다.
20 ms 기준 음소 경계 F1은 단어 타임스탬프 F1과 같은 지표를 음과 음 사이의 경계에 적용한 것입니다.
Olewave는 FA-Bench와 Olign을 모두 만듭니다. 그래서 Olign은 FA-Bench 리더보드에서 순위 없이 표 맨 아래에 나옵니다. 이 글에서 FA-Bench는 공개되어 있고 재현할 수 있는 측정 기준으로 쓰입니다. 순위는 매기지 않습니다.
타임스탬프가 있는 ASR
오디오만 보냅니다.
단어 타임스탬프 F1은 네 테스트 세트 모두에서 올랐습니다. 가장 크게 오른 곳은 깨끗한 Buckeye로, 0.660에서 0.702입니다. 단어 오류율은 거의 그대로였고, 평균 7.5%에서 7.4%입니다. 즉, 좋아진 것은 타이밍입니다.
모든 수치
| TIMIT 깨끗한 음성 | TIMIT 잡음 음성 | Buckeye 깨끗한 음성 | Buckeye 잡음 음성 | 4개 평균 | |
|---|---|---|---|---|---|
| 단어 타임스탬프 F1, Olign 1.0 | 0.786 | 0.695 | 0.660 | 0.585 | 0.681 |
| 단어 타임스탬프 F1, Olign 1.1 | 0.804 | 0.726 | 0.702 | 0.615 | 0.712 |
| 단어 오류율, Olign 1.0 | 2.2% | 3.2% | 10.2% | 14.3% | 7.5% |
| 단어 오류율, Olign 1.1 | 2.2% | 3.2% | 9.9% | 14.2% | 7.4% |
강제 정렬
오디오와 그 전사문을 보냅니다.
단어 타임스탬프 F1은 네 테스트 세트 모두에서 올랐고, 단어 경계 오차는 네 곳 모두에서 줄었습니다. 단어 경계 오차가 가장 크게 줄어든 곳은 잡음이 있는 TIMIT로, 33.0 ms에서 25.7 ms입니다. 음소 경계 F1은 모든 곳에서 조금씩 올라, 평균 0.452에서 0.458입니다. 변화의 대부분은 단어의 가장자리에서 일어납니다.
모든 수치
| TIMIT 깨끗한 음성 | TIMIT 잡음 음성 | Buckeye 깨끗한 음성 | Buckeye 잡음 음성 | 4개 평균 | |
|---|---|---|---|---|---|
| 단어 타임스탬프 F1, Olign 1.0 | 0.805 | 0.710 | 0.755 | 0.668 | 0.735 |
| 단어 타임스탬프 F1, Olign 1.1 | 0.824 | 0.747 | 0.775 | 0.689 | 0.759 |
| 단어 경계 오차, Olign 1.0 | 18.2 ms | 33.0 ms | 22.4 ms | 43.8 ms | |
| 단어 경계 오차, Olign 1.1 | 17.0 ms | 25.7 ms | 18.7 ms | 38.8 ms | |
| 음소 경계 F1, Olign 1.0 | 0.410 | 0.393 | 0.523 | 0.483 | 0.452 |
| 음소 경계 F1, Olign 1.1 | 0.413 | 0.396 | 0.529 | 0.492 | 0.458 |
달라진 점
Olign 릴리스와 API는 버전 번호가 따로 있습니다. 아래에 둘 다 적었습니다.
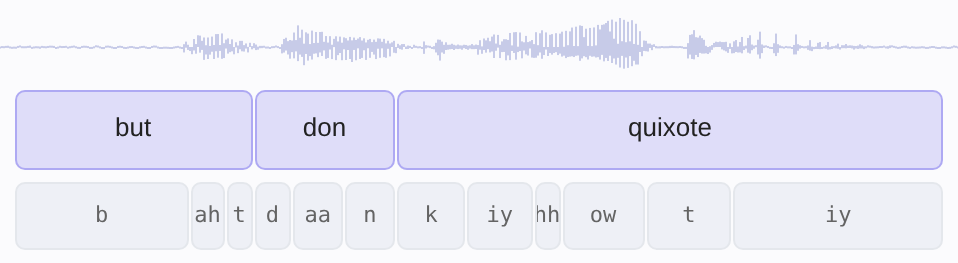
쉼이 실제 길이에 가까워졌습니다. 릴리스 1.1.3 전에는 쉼 앞의 단어가 쉼 안으로 이어졌습니다. Buckeye 테스트에서 그 폭은 중앙값으로 약 80에서 90 ms였습니다. 그래서 쉼이 실제보다 짧게 돌아왔습니다. 이제는 단어가 소리가 끝나는 곳에서 끝나고, 중앙값은 몇 밀리초 이내입니다. 자막과 더빙은 쉼에서 음성을 나누므로, 이 변화가 중요합니다.
모든 결과에 쉼과 구절. API v1.1.0부터 각 결과에 목록이 두 개 더 있습니다. pauses에는 어떤 단어도 덮지 않는 0.05초 이상의 구간이 모두 들어 있습니다. phrases는 0.1초 이상의 쉼마다 단어를 나눕니다. 단어 일곱 개로 된 4.5초짜리 클립에서는 다음과 같습니다.
"pauses": [
  {"begin": 0.0, "end": 0.47},
  {"begin": 0.75, "end": 0.84},
  {"begin": 1.132, "end": 1.213},
  {"begin": 1.89, "end": 2.173},
  {"begin": 4.36, "end": 4.48}
],
"phrases": [
  {"begin": 0.47, "end": 1.89, "words": [0, 2]},
  {"begin": 2.173, "end": 4.36, "words": [3, 6]}
]
단어 사이의 쉼 가운데 0.1초 이상인 것이 하나 있어서, 이 클립은 두 구절이 됩니다. words는 각 구절의 첫 단어와 마지막 단어를 알려 줍니다.
두 가지 단어 가장자리. API v1.2.0부터 단어 시간을 매기는 방식을 고를 수 있습니다. word_edges=phonetic이 기본값이며, 음성학자가 경계를 두는 곳에 가장자리를 둡니다. word_edges=audible은 각 단어를 귀에 들리는 곳에서 시작하고 끝냅니다. 이때 p, t, k, b, d, g 앞의 무음은 단어 밖에 남습니다. 더빙과 자막에 필요한 방식입니다. audible 가장자리는 스튜디오 수준의 깨끗한 녹음에 쓰세요.
curl https://api.olewave.com/olign/v1 \
  -H "X-API-Key: $OLIGN_KEY" \
  -F [email protected] \
  -F [email protected] \
  -F word_edges=audible
첫 단어와 숨소리. 첫 단어가 그 앞의 숨소리나 잡음 속에서 시작하는 일이 없어졌습니다. p, t, k, b, d, g로 시작하는 첫 단어는 파열 앞의 무음을 최대 30 ms까지만 포함합니다. 쉼 뒤의 단어도 그 앞의 숨소리 속에서 시작하지 않습니다.
이름과 새 단어. 릴리스 1.1.0부터 사람 이름, 브랜드 이름, 새 단어도 발음을 얻고, 그 단어 자신의 소리에 맞춰 정렬됩니다. 전에는 이런 단어가 음소 없이 돌아왔고, 앞뒤 단어가 그 타이밍 오류를 떠안았습니다.
긴 녹음. 녹음의 맨 처음과 맨 끝 단어가 더 이상 잘리거나 빠지지 않습니다. 이웃한 두 단어가 겹치는 일도 없어졌습니다.
옮겨 갈 작업이 없습니다. API 변경은 추가만 있습니다. Olign 1.0에서 작동하던 요청은 Olign 1.1에서도 작동하고, audible 가장자리를 위한 예전 옵션 이름도 계속 쓸 수 있습니다.
이 수치를 읽는 법
테스트는 영어만 다루며, 낭독 음성과 대화 음성이 대상입니다. FA-Bench는 Olewave의 자체 벤치마크이고, Olign은 거기에 순위 없이 실려 있습니다. 채점기는 GitHub에 공개되어 있고, TIMIT과 Buckeye는 누구나 라이선스를 받을 수 있습니다. 같은 오디오를 Olign에 보내고 돌아온 결과를 직접 채점해 보세요.