


Meta의 Movie Gen vs. OpenAI의 Sora: 상세 리뷰
Meta는 마침내 Sora에 대한 입장을 보였고, Movie Gen은 단순한 비디오 생성기 이상입니다 — 다중 aspect ratio로 1080p HD 비디오를 생성하고 동기화된 오디오를 지원하는 foundation 모델의 캐스트이며, 정밀합니다

Google 연구원의 End-to-End 음성 인식에 대한 심층 분석, Part 1: 개요 & 모델링
딥러닝의 10년은 ASR 단어 오류율을 50% 이상 상대적으로 감소시켰고, 그 과정에서 고전적인 HMM 파이프라인을 유물처럼 보이게 만들었습니다.

OpenAI GPT-4o의 신경망 아키텍처 추론하기
OpenAI는 GPT-4o에 대한 논문을 발표하지 않았으므로, 이 영상은 다음 최선의 방법을 제시합니다: OpenAI가 실제로 시연한 기능을 바탕으로 신경망 아키텍처가 거의 확실히 어떤 모습인지를 역엔지니어링합니다

Google의 100개 이상 언어를 지원하는 Universal Speech Model이 OpenAI의 Whisper Model을 능가합니다
Google의 Universal Speech Model은 조용히 놀라운 성과를 달성했습니다: 레이블이 지정된 훈련 데이터의 약 1/7을 사용하면서 100개 이상의 언어에서 OpenAI의 Whisper와 동등하거나 능가하는 ASR 성능을 달성했습니다.
OpenAI GPT-4의 비전+텍스트 모델, 데이터 및 학습 비용 공개 (추측)
OpenAI는 GPT-4의 아키텍처, 파라미터 수, 학습 데이터 또는 컴퓨팅 예산을 공개하지 않기로 악명높으며, 이는 기술 보고서를 ML 커뮤니티를 위한 로르샤흐 테스트로 바꾸었습니다.

GPT-4의 기술 보고서 리뷰 (한눈에 보는 GPT-4)
GPT-4의 기술 보고서는 아키텍처 세부사항이 부족하고 능력 주장이 많기로 악명높으며, 이는 명확한 리뷰를 그 위에 구축하는 모든 사람을 위해 필수 읽기로 만듭니다.
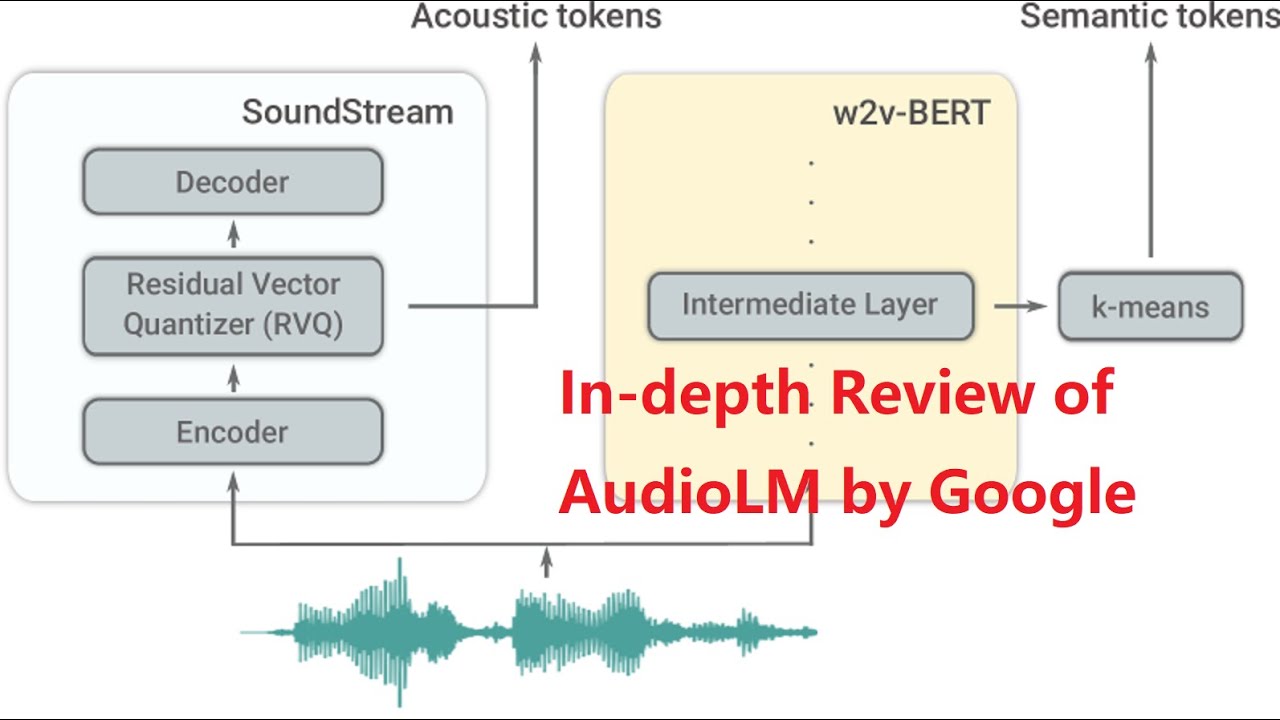
[Olewave의 리뷰] AudioLM: 오디오 생성을 위한 언어 모델링 접근
AudioLM은 많은 사람들에게 오디오 생성이 신호 처리보다는 언어 모델링처럼 보여야 한다고 확신시킨 논문입니다.

OpenAI의 GPT-3에 대한 심층 리뷰 : 언어 모델은 소수 샷 학습자입니다 (파트 3/3: 결과 및 나머지)
이 3부작 GPT-3 심층 분석의 최종 회차는 결과에 도달합니다: 1,750억 개의 파라미터를 벤치마크 스위트에 투입하고 미세 조정을 완전히 건너뛸 때 실제로 어떤 일이 발생하는지에 대해.
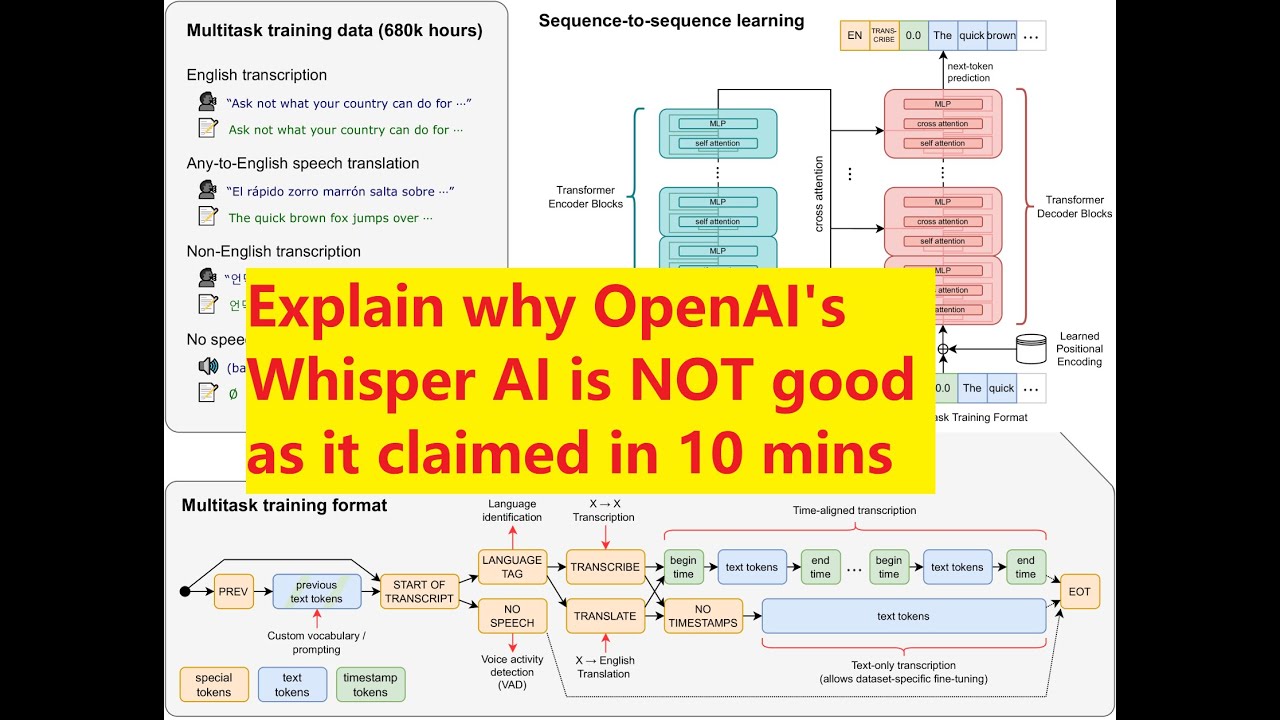
[10분] OpenAI의 Whisper API가 ChatGPT만큼 좋지 않은 이유 설명
Whisper는 큰 성공을 거두었지만, GPT-3이 NLP를 재편했던 방식으로 ASR을 재편하지는 못했습니다. 이 10분짜리 리뷰는 그 이유가 논문 자체에 내재되어 있다고 주장합니다.

OpenAI의 GPT-3에 대한 심층 검토: 언어 모델은 Few-Shot 학습자입니다 (파트 2/3: 결과)
이 GPT-3 심층 분석의 2부는 설정을 넘어 실제로 사람들이 NLP를 재생각하게 한 결과로 이동합니다.
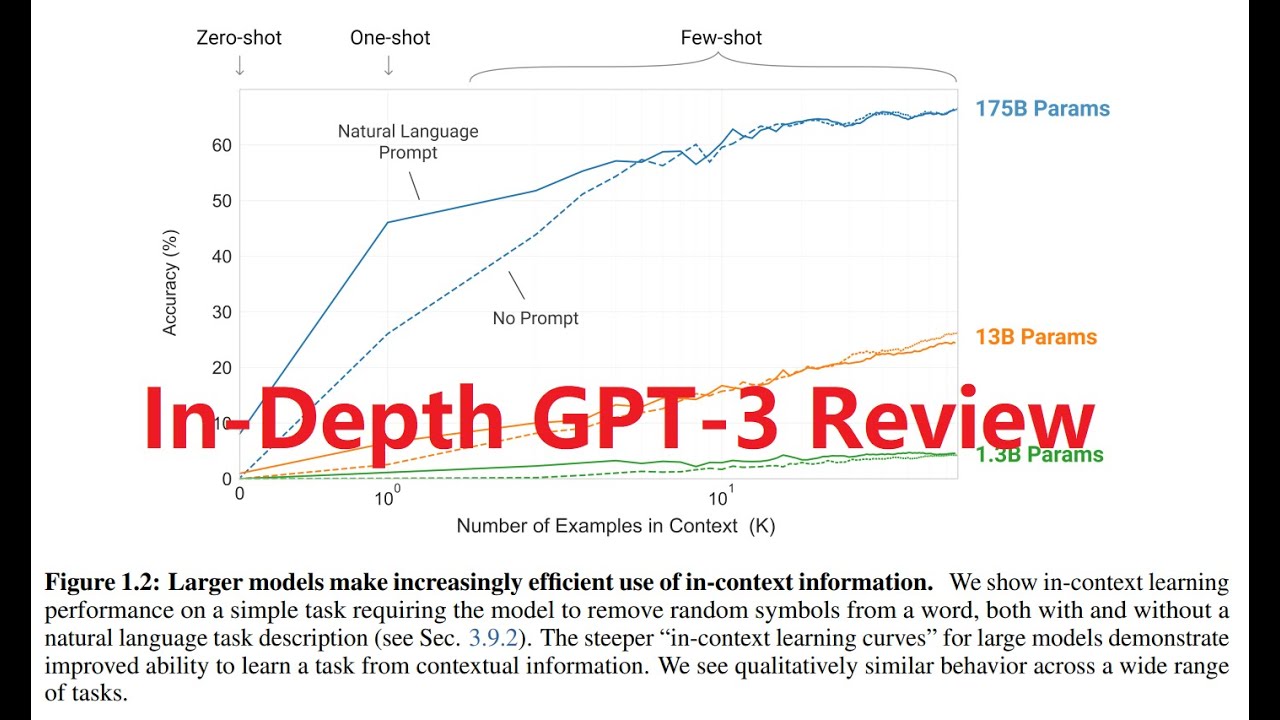
OpenAI의 GPT-3에 대한 심층 검토: 언어 모델은 Few-Shot 학습자입니다 (파트 1/3: 소개 & 접근)
이 세 부분 GPT-3 검토의 첫 번째 부분은 규모를 연구 베팅에서 업계 복음으로 바꾼 논문을 설정합니다.

ChatGPT/ChatGPT Plus/InstructGPT: 인간 피드백으로 지시를 따르도록 언어 모델 훈련
ChatGPT 제품 뒤에는 InstructGPT 논문이 있으며, 이 상세 리뷰는 원시 GPT-3을 사람들이 실제로 대화하고 싶어 하는 것으로 변환한 파이프라인을 자세히 분석합니다.

3분 안에 ChatGPT/ChatGPT Plus가 어떻게 작동하는지 설명
ChatGPT는 외부에서는 마법처럼 보이지만, 어디를 봐야 하는지 알면 레시피는 잘 문서화되어 있으며, 이 3분 설명은 핵심 아이디어를 요약합니다.

[Olewave's Review] CLIP (3/3): 자연어 감독으로부터의 전이 가능한 시각 모델 학습
이 CLIP 검토의 마지막 부분은 결과 섹션에 도달하며, 여기서 OpenAI의 대조적 이미지-텍스트 모델이 흥미로운 아이디어에서 전체 멀티모달 스택의 기초 계층 기본 요소로 전환되었습니다.

[Olewave's Review] CLIP (2/3): 자연어 감독으로부터의 전이 가능한 시각 모델 학습
OpenAI의 CLIP은 고정 레이블 세트를 버리고 대신 인터넷에서 수집한 4억 개의 (이미지, 텍스트) 쌍으로 훈련함으로써 컴퓨터 비전의 스크립트를 뒤집었습니다.

[Olewave's Review] CLIP (1/3): 자연어 감독으로부터의 전이 가능한 시각 모델 학습
BLIP, LLaVA, 또는 가치 있는 음성-LLM이 있기 전에 CLIP이 있었으며, 이것이 이야기가 시작되는 곳입니다.

[Olewave의 리뷰] OpenAI의 Whisper ASR: 대규모 약한 지도를 통한 강건한 음성 인식
OpenAI가 Whisper를 출시했을 때, ASR 커뮤니티는 68만 시간의 다국어, 다중 작업, 웹 크롤링 오디오로 훈련되어 사투리, 배경 소음, 기술 용어 전반에 걸쳐

[장문 리뷰] Cascaded Diffusion Models for High Fidelity Image Generation
Imagen과 DALL-E 2가 생성 이미지를 위한 확산을 기본값으로 만들기 전에, 이 Google Brain 논문은 이후 많은 텍스트-이미지 시스템이 조용히 차용한 cascaded diffusion 레시피를 제시했습니다: 작은

[단문 리뷰] Cascaded Diffusion Models for High Fidelity Image Generation
Cascaded diffusion은 많은 최신 생성 작업의 기저를 이루는 다단계 레시피입니다: 한 개의 diffusion 모델로 작은 이미지를 생성한 후, 고주파 세부