


Google 연구원의 End-to-End 음성 인식에 대한 심층 분석, Part 1: 개요 & 모델링
딥러닝의 10년은 ASR 단어 오류율을 50% 이상 상대적으로 감소시켰고, 그 과정에서 고전적인 HMM 파이프라인을 유물처럼 보이게 만들었습니다.

OpenAI GPT-4o의 신경망 아키텍처 추론하기
OpenAI는 GPT-4o에 대한 논문을 발표하지 않았으므로, 이 영상은 다음 최선의 방법을 제시합니다: OpenAI가 실제로 시연한 기능을 바탕으로 신경망 아키텍처가 거의 확실히 어떤 모습인지를 역엔지니어링합니다

Google의 100개 이상 언어를 지원하는 Universal Speech Model이 OpenAI의 Whisper Model을 능가합니다
Google의 Universal Speech Model은 조용히 놀라운 성과를 달성했습니다: 레이블이 지정된 훈련 데이터의 약 1/7을 사용하면서 100개 이상의 언어에서 OpenAI의 Whisper와 동등하거나 능가하는 ASR 성능을 달성했습니다.

[상세 논문 읽기] Zipformer: 자동 음성 인식을 위한 더 빠르고 나은 인코더
Conformer은 수년 동안 기본 ASR 인코더였지만, k2/icefall 팀의 Zipformer은 더 빠르고 가벼우면서도 LibriSpeech, Aishell-1, WenetSpeech에서 조용히 WER 왕관을 차지했습니다.

Google의 SoundStream 심층 리뷰: 엔드-투-엔드 신경 오디오 코덱
신경 코덱은 조용히 현대 생성 오디오의 기초 계층이 되었고, SoundStream은 시작을 신호한 논문 중 하나입니다.
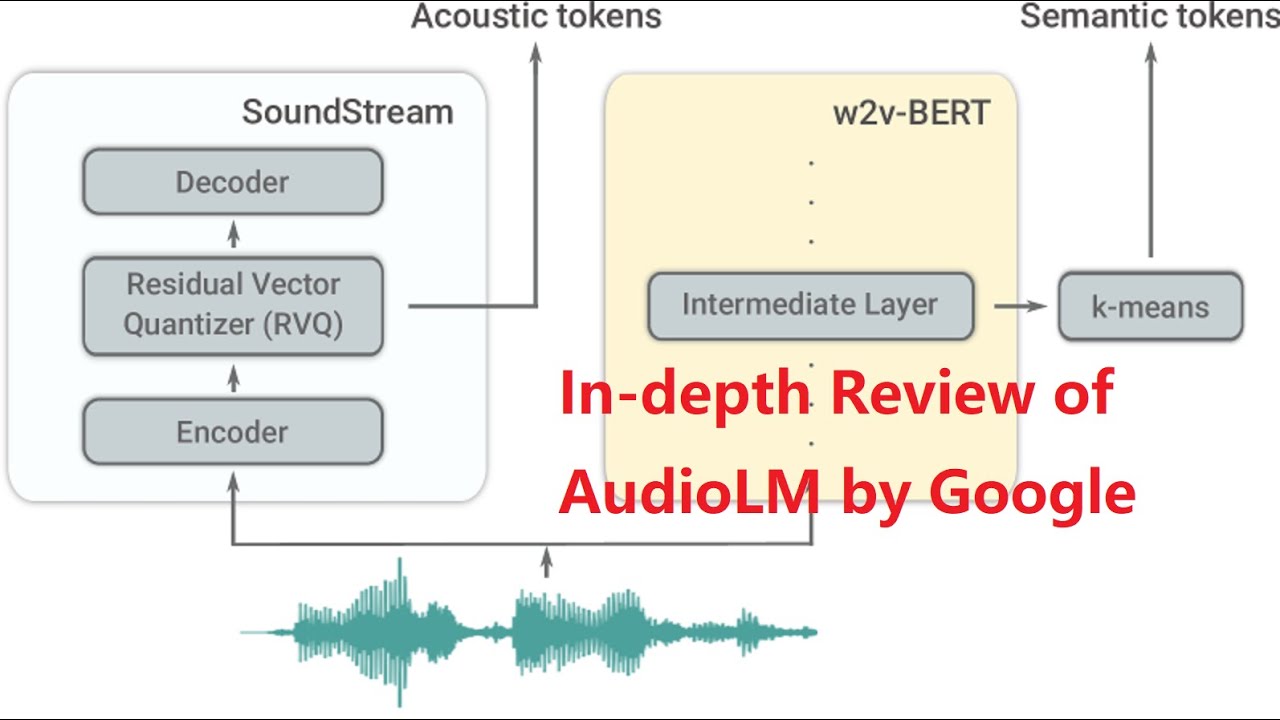
[Olewave의 리뷰] AudioLM: 오디오 생성을 위한 언어 모델링 접근
AudioLM은 많은 사람들에게 오디오 생성이 신호 처리보다는 언어 모델링처럼 보여야 한다고 확신시킨 논문입니다.
Olewave의 RNN-T 설명 중 가장 상세함: Sequence Transduction with Recurrent Neural Networks
Alex Graves의 RNN-T 논문은 오늘날 출시되는 거의 모든 스트리밍 ASR 시스템의 조용한 조상이며, Google의 온디바이스 인식기에서부터 NeMo, ESPnet 등의 수많은 오픈소스 트랜스듀서 스택에 이르기까지입니다.

Google이 AI 봇이 센티언트라고 말한 Blake Lemoine을 해고했나? LaMDA나 ChatGPT가 인간처럼 생각할까?
Google이 LaMDA가 센티언트가 되었다는 주장을 공개한 Blake Lemoine을 해고했을 때, 그 이야기는 바이럴이 되었지만, 근본적인 질문이 남았습니다: LaMDA와 ChatGPT와 같은 대규모 언어 모델이 실제로 생각을

[Olewave의 장편 리뷰] Xception: 깊이별 분리형 컨볼루션을 이용한 딥러닝
Xception은 Inception 가설을 논리적 극단까지 밀어붙이고 채널 간 및 공간적 상관관계를 완전히 분리된 연산으로 밀어붙였으며, 이로 인해 인기를 얻은 깊이별 분리형 컨볼루션은 이제 모든 곳에 나타난다
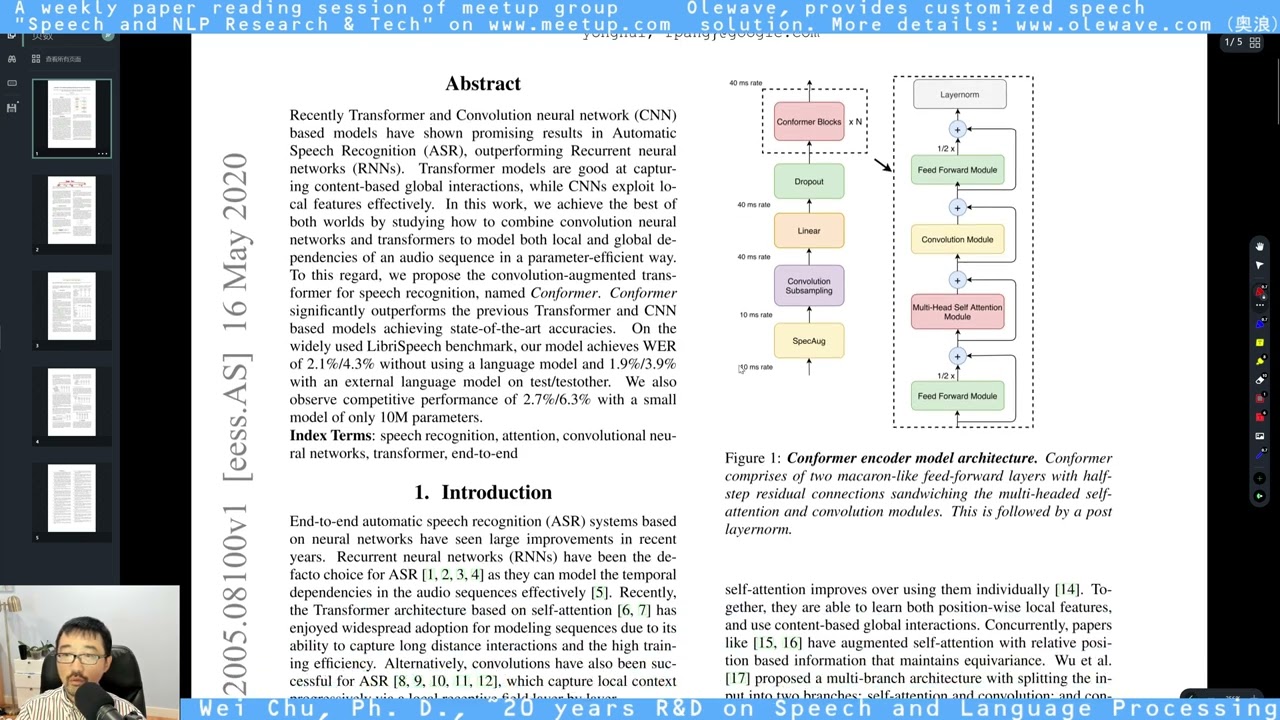
[Olewave의 단편 리뷰] Xception: 깊이별 분리형 컨볼루션을 이용한 딥러닝
Xception의 핵심 아이디어만 원하고 장편 리뷰의 깊은 내용은 원하지 않는다면, 이 단편 리뷰가 간단한 버전입니다.

[Long Review] CLAS: 깊은 문맥: 종단간 문맥적 음성 인식
ASR 제품을 출시한 사람이라면 누구나 고유명사의 고통을 알고 있습니다: 연락처 이름, 노래 제목, 약물 이름, 모호한 장소 이름.


[긴 리뷰] 미세조정된 언어 모델은 제로샷 학습자
InstructGPT가 지시어 튜닝을 일상적인 표현으로 만들기 전에, Google의 FLAN 논문은 자연어 지시어에 대한 적당한 양의 다중 작업 미세조정이 평범한 LM을 놀랍도록 c

[긴 리뷰] 'GShard': 조건부 연산 및 자동 샤딩으로 거대 모델 확장
Transformer를 100억 개 이상의 매개변수로 확장하는 것은 빠르게 철학적이 됩니다: 모든 토큰에 대해 전체 네트워크를 활성화하거나 각 토큰을 실제로 봐야 하는 전문가에게 라우팅합니까?