


마이크로소프트의 VALL-E 2 검토 (Zero-shot TTS에서 인간 수준 달성)
Zero-shot TTS는 많은 사람들이 여전히 몇 년 먼 것이라고 생각했던 선을 넘었습니다. 마이크로소프트의 VALL-E 2는 견고성, 자연스러움, 화자 유사성 측면에서 LibriSpeech와 VCTK 모두에서 인간 수준에 도달한 첫 번째 신경망 코덱 언어 모델입니다.
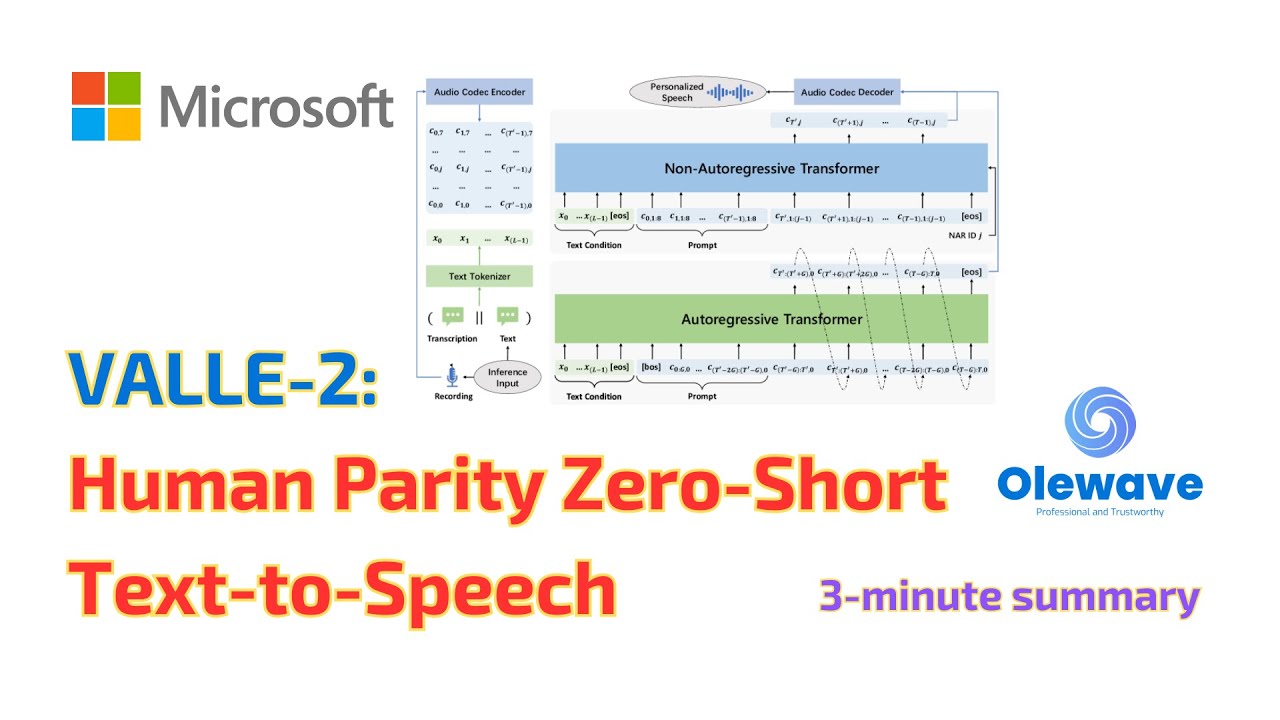
3분 안에 마이크로소프트의 VALL-E 2 이해하기 (Zero-shot TTS에서 인간 수준 달성)
시간이 부족하지만 VALL-E 2가 갑자기 zero-shot TTS의 기준점이 된 이유를 알아야 합니까?
OpenAI Whisper에서 자체 ASR 서비스로: 이름 엔티티 및 도메인별 용어 인식
Whisper는 즉시 인상적이지만, 실제로 프로덕션에 배포한 사람이라면 누구나 고통을 알고 있습니다: 고유명사, 제품 이름, 의료 용어, 법률 용어, 그리고 도메인 어휘의 전체 긴 꼬리를 잘못 처리합니다

Google 연구원의 End-to-End 음성 인식에 대한 심층 분석, Part 1: 개요 & 모델링
딥러닝의 10년은 ASR 단어 오류율을 50% 이상 상대적으로 감소시켰고, 그 과정에서 고전적인 HMM 파이프라인을 유물처럼 보이게 만들었습니다.

OpenAI GPT-4o의 신경망 아키텍처 추론하기
OpenAI는 GPT-4o에 대한 논문을 발표하지 않았으므로, 이 영상은 다음 최선의 방법을 제시합니다: OpenAI가 실제로 시연한 기능을 바탕으로 신경망 아키텍처가 거의 확실히 어떤 모습인지를 역엔지니어링합니다

Google의 100개 이상 언어를 지원하는 Universal Speech Model이 OpenAI의 Whisper Model을 능가합니다
Google의 Universal Speech Model은 조용히 놀라운 성과를 달성했습니다: 레이블이 지정된 훈련 데이터의 약 1/7을 사용하면서 100개 이상의 언어에서 OpenAI의 Whisper와 동등하거나 능가하는 ASR 성능을 달성했습니다.
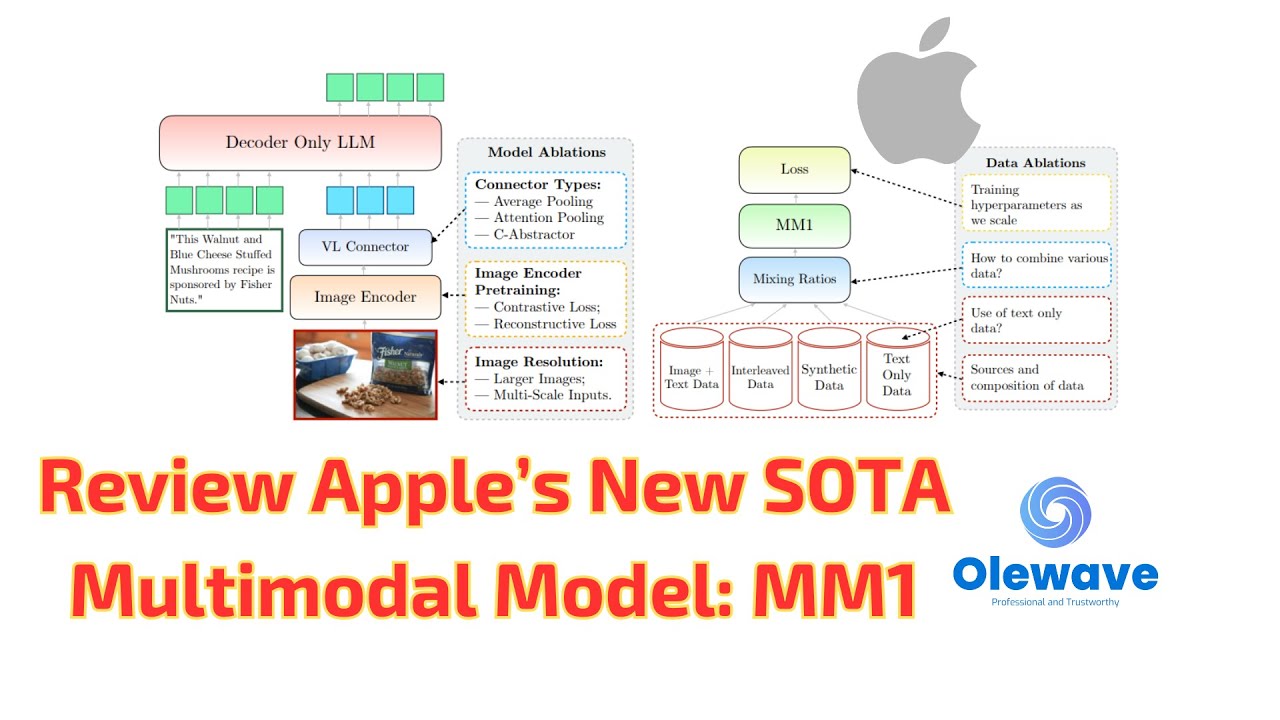
긴 리뷰: Apple의 MM1: 멀티모달 LLM 사전 학습의 방법, 분석 및 인사이트
Apple은 많이 출판하지 않으므로, MM1 논문이 멀티모달 LLM 사전 학습에 대한 완전한 제거 연구와 함께 발표되었을 때, MLLM을 구축하는 모든 사람에게 올해 더 유용한 데이터 릴리스 중 하나였습니다.

Apple의 SOTA 멀티모달 LLM의 빠른 리뷰: MM1
MM1의 전체 분석에 시간이 없다면, 이 빠른 리뷰는 몇 분 안에 핵심을 제공합니다: Apple이 구축한 것, 아키텍처 및 데이터의 제거 연구에서 배운 것, 그리고 어떤 설계 결정이

Claude 3이 GPT-4를 능가하게 만든 비결
Claude 3 Opus가 MMLU, GPQA, GSM8K 및 대부분의 경계 평가 벤치마크에서 GPT-4를 능가했을 때, 흥미로운 질문은 Anthropic이 단순히 더 크게 확장했는지 여부가 아니라 어떤 학습 시간 비결이었는지였습니다.
Microsoft+OpenAI, Google, Meta, 및 Nvidia의 오픈 소스 대규모 음성 모델 검토(ASR용)
모든 주요 AI 연구소는 이제 ASR용 오픈 소스 대규모 음성 모델을 출시했으며, 프로덕션용으로 올바른 모델을 선택하는 것이 실제 결정이 되었습니다.

OpenAI의 Whisper 모델에서 자신의 자체 ASR 서비스로: 후처리 및 언어 모델링
원본 Whisper 출력은 기본 상태에서 인상적이지만, 실제 사용자에게 배포한 모든 사람은 데모 트랜스크립트와 다운스트림 시스템이 실제로 사용할 수 있는 것 사이의 간격을 알고 있습니다.

OpenAI의 Whisper 모델에서 자신의 자체 ASR 서비스로: 긴 오디오 및 스트리밍 (Part 3)
Whisper는 30초 청크로 학습되었으며, 2시간 팟캐스트를 입력하거나 라이브 캡션 파이프라인에 연결하려고 할 때 한계를 드러냅니다.
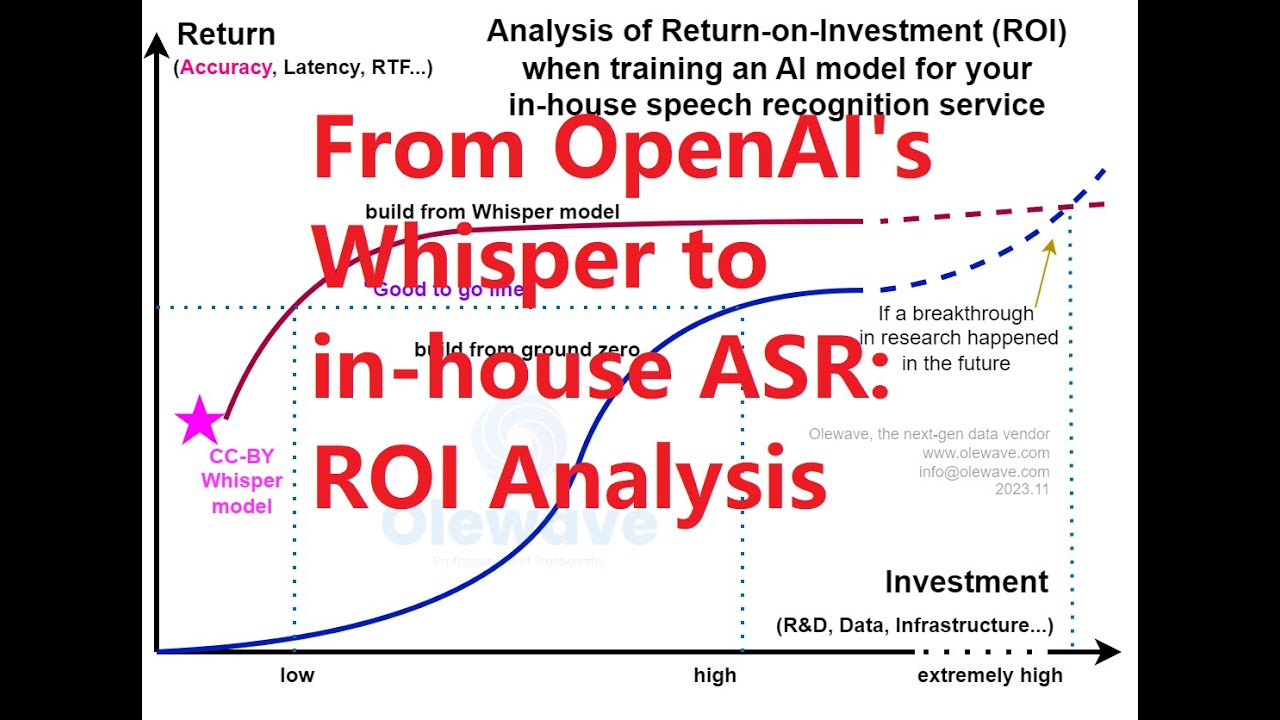
OpenAI의 Whisper 모델에서 자신의 자체 ASR 서비스로: ROI (투자 수익률) (Part 2)
ASR의 구축 대 구매 질문은 일반적으로 정확도 대 편의성으로 프레임화되지만, 실제 결정 요소는 제품 수명 동안의 ROI입니다.
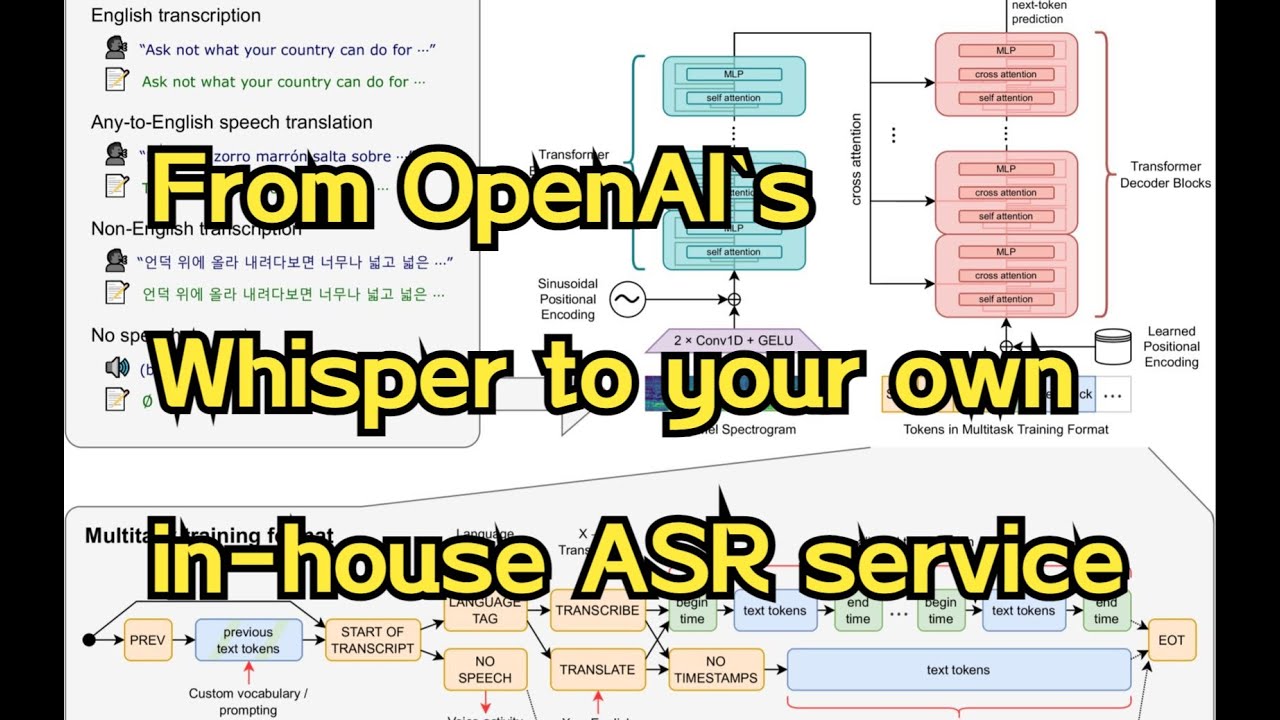
OpenAI의 Whisper 모델에서 자신의 자체 ASR 서비스로: 개요 (Part 1)
OpenAI가 Whisper를 오픈소스로 공개했을 때, 자체 ASR 서비스가 어떻게 보이는지에 대한 기준선을 조용히 재설정했습니다.

OpenAI Whisper가 생성한 단어 타임스탐프가 정확하지 않은 이유는? 다시 정확하게 만들 수 있을까?
Whisper에 단어 타임스탐프를 요청하면 숫자가 반환됩니다 — 하지만 실제 오디오와 맞춰보려고 시도한 경험이 있다면, 노래방, 자막, 더빙을 위해 드리프트가 발생하고 잘못된 경계로 스냅되며 가끔은

음성 생성 AI: Meta AI의 VoiceBox(Flow Matching과 Neural ODE도)
수년 동안 음성 생성은 규모와 일반성 측면에서 텍스트 및 이미지 생성에 뒤떨어졌습니다 — 모든 작업은 자체 맞춤형 모델을 사용했습니다.

SpeechT5 리뷰: 음성(ASR, TTS, SID, ...) 작업에 Google의 T5 도입하기
T5는 단일 인코더-디코더 사전 훈련 방식 아래에서 텍스트-텍스트 작업을 통합했으며 NLP의 핵심 도구가 되었습니다.
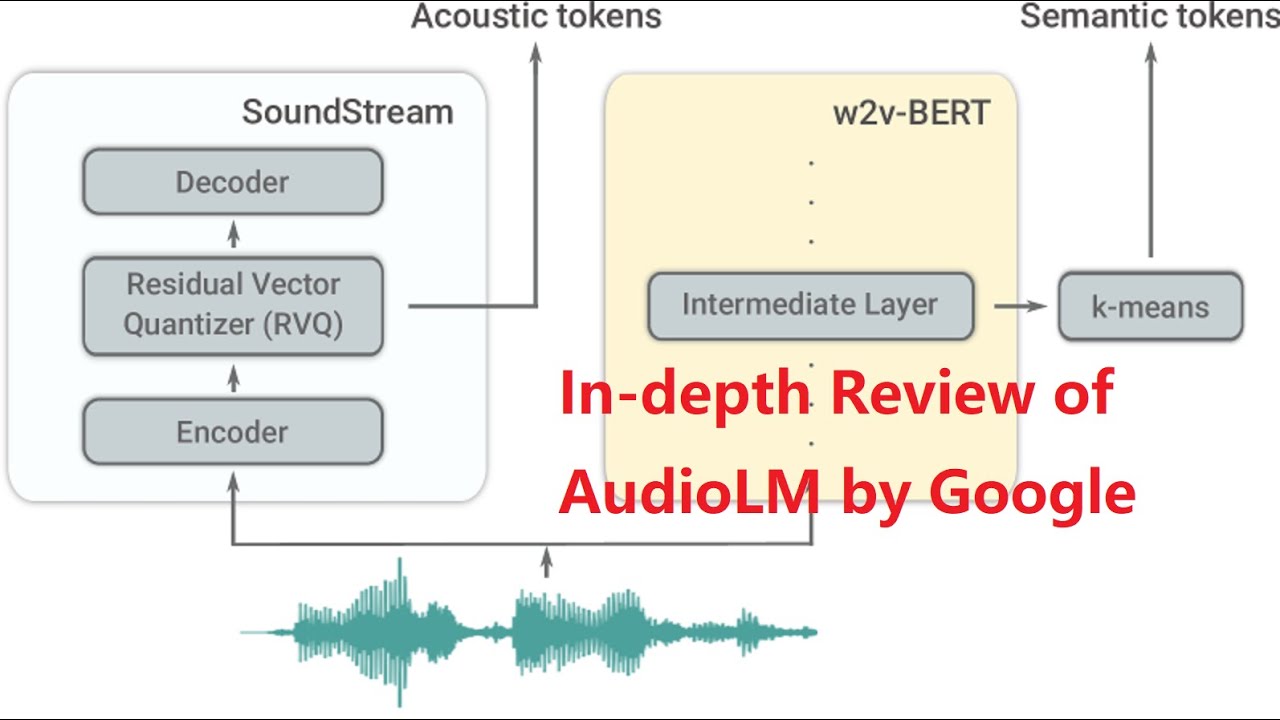
[Olewave의 리뷰] AudioLM: 오디오 생성을 위한 언어 모델링 접근
AudioLM은 많은 사람들에게 오디오 생성이 신호 처리보다는 언어 모델링처럼 보여야 한다고 확신시킨 논문입니다.
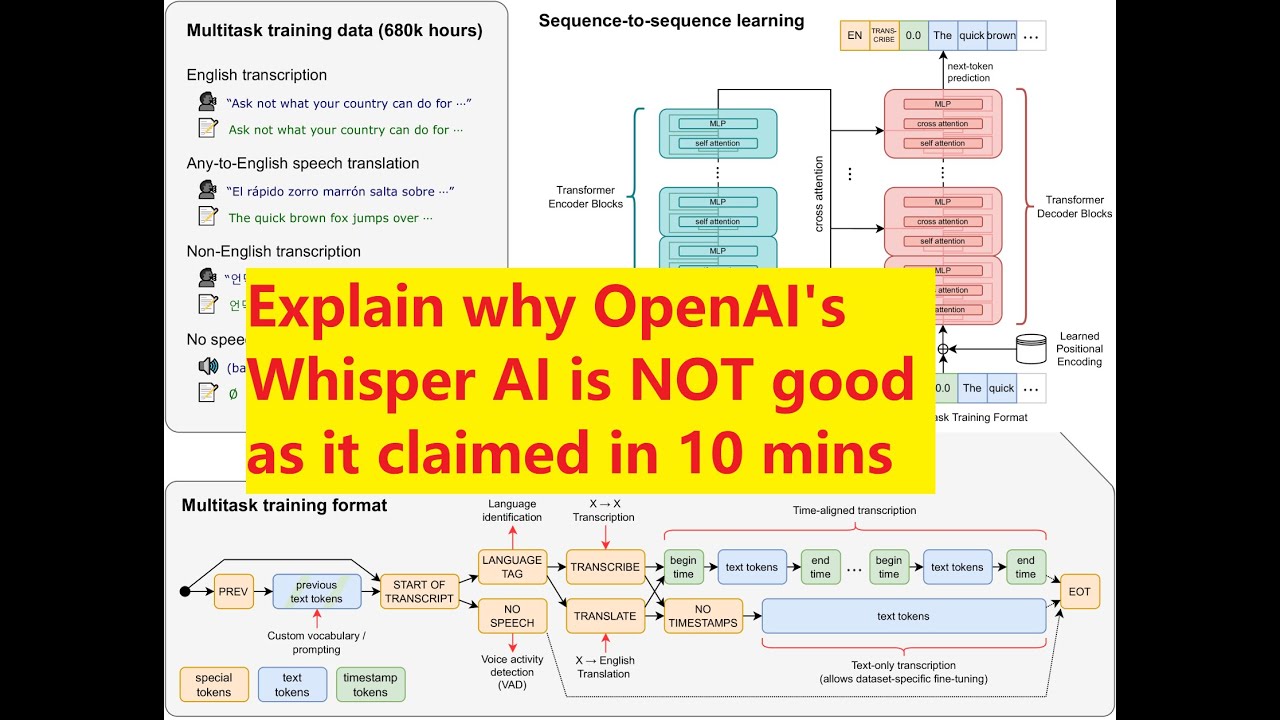
[10분] OpenAI의 Whisper API가 ChatGPT만큼 좋지 않은 이유 설명
Whisper는 큰 성공을 거두었지만, GPT-3이 NLP를 재편했던 방식으로 ASR을 재편하지는 못했습니다. 이 10분짜리 리뷰는 그 이유가 논문 자체에 내재되어 있다고 주장합니다.
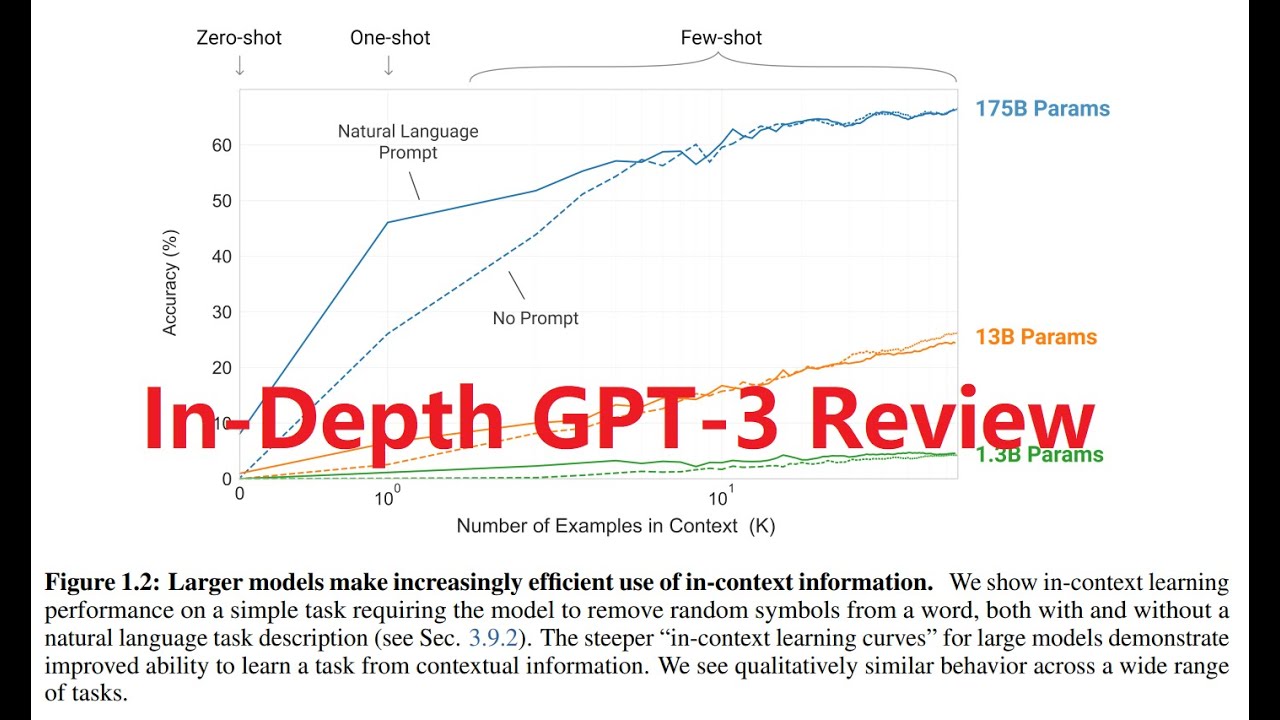
OpenAI의 GPT-3에 대한 심층 검토: 언어 모델은 Few-Shot 학습자입니다 (파트 1/3: 소개 & 접근)
이 세 부분 GPT-3 검토의 첫 번째 부분은 규모를 연구 베팅에서 업계 복음으로 바꾼 논문을 설정합니다.
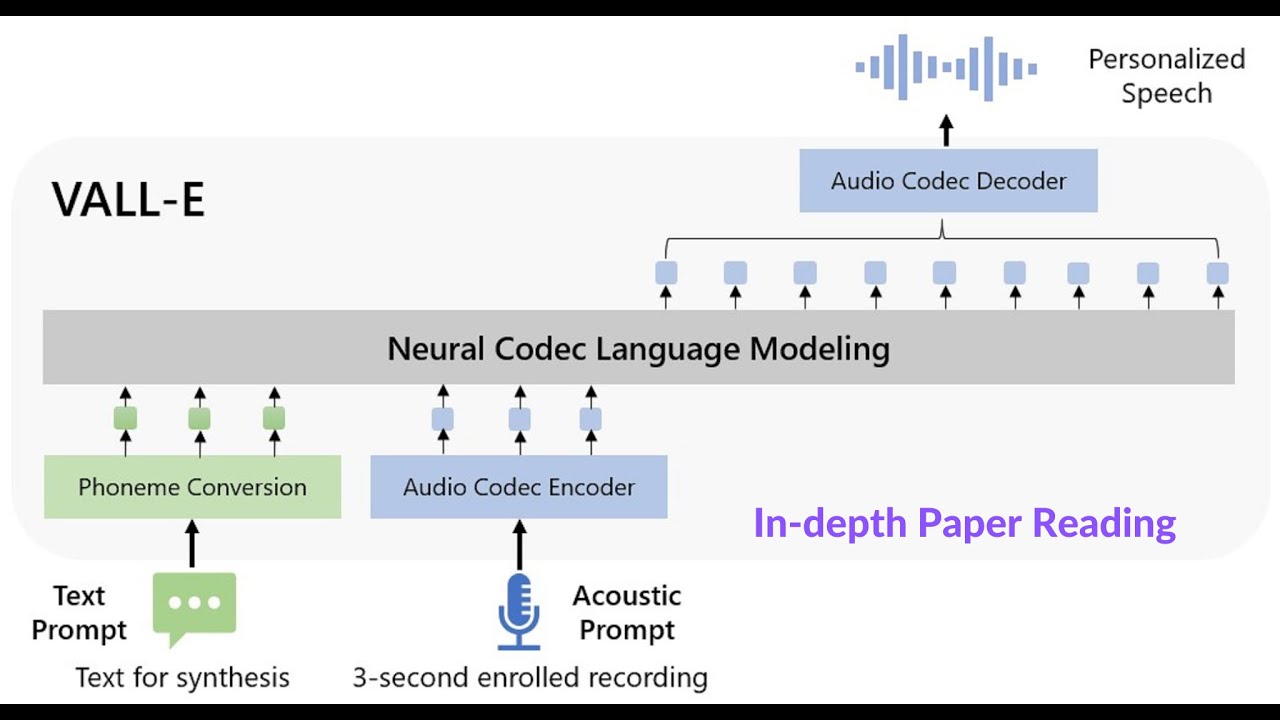
VALL-E의 심층 리뷰: 신경 코덱 언어 모델이 영샷 텍스트 음성 합성기
3초 참고 클립으로부터의 영샷 TTS는 VALL-E가 출시될 때까지 불가능해 보였지만, 이 심층 리뷰는 Microsoft가 정확히 어떻게 이를 달성했는지를 상세히 설명합니다.
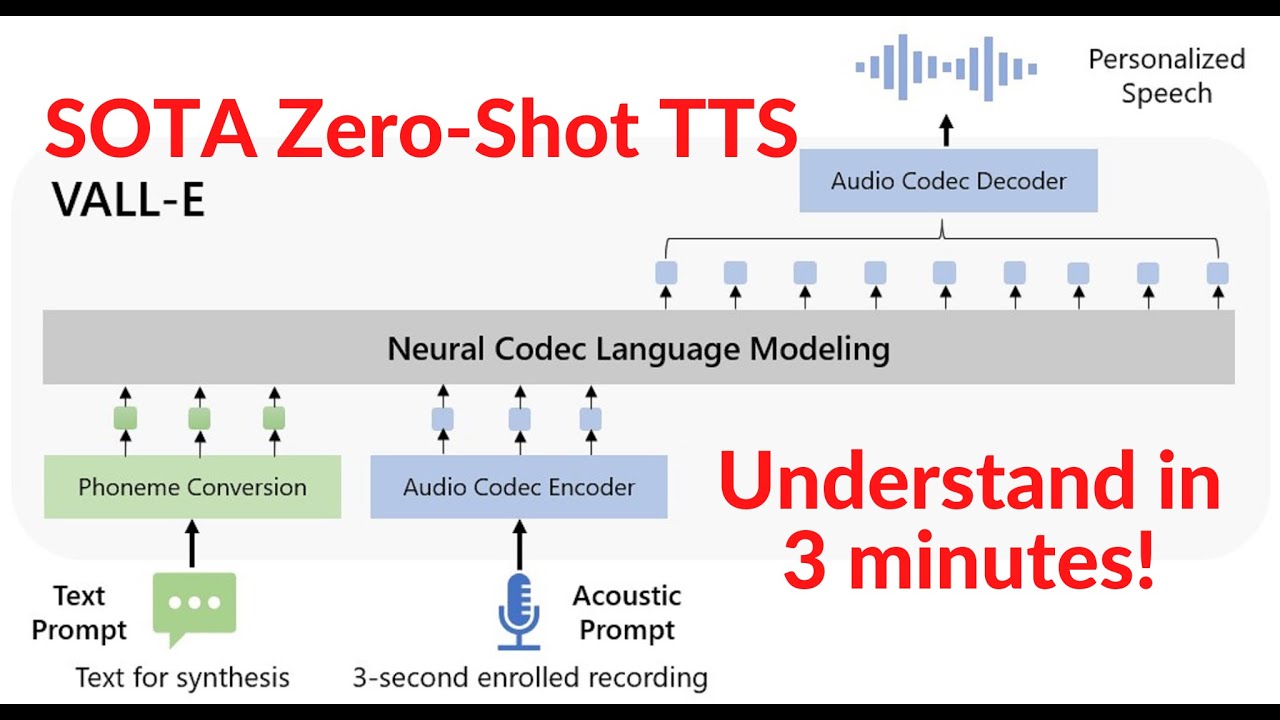
3분 안에 Microsoft의 VALL-E 이해하기 (최고 성능 영샷 TTS)
VALL-E는 TTS가 신호 회귀처럼 보이기를 멈추고 언어 모델링처럼 보이기 시작한 순간이며, 이 빠른 설명은 당신을 신속하게 이해하도록 도와줍니다.

[Olewave의 리뷰] OpenAI의 Whisper ASR: 대규모 약한 지도를 통한 강건한 음성 인식
OpenAI가 Whisper를 출시했을 때, ASR 커뮤니티는 68만 시간의 다국어, 다중 작업, 웹 크롤링 오디오로 훈련되어 사투리, 배경 소음, 기술 용어 전반에 걸쳐
Olewave의 RNN-T 설명 중 가장 상세함: Sequence Transduction with Recurrent Neural Networks
Alex Graves의 RNN-T 논문은 오늘날 출시되는 거의 모든 스트리밍 ASR 시스템의 조용한 조상이며, Google의 온디바이스 인식기에서부터 NeMo, ESPnet 등의 수많은 오픈소스 트랜스듀서 스택에 이르기까지입니다.
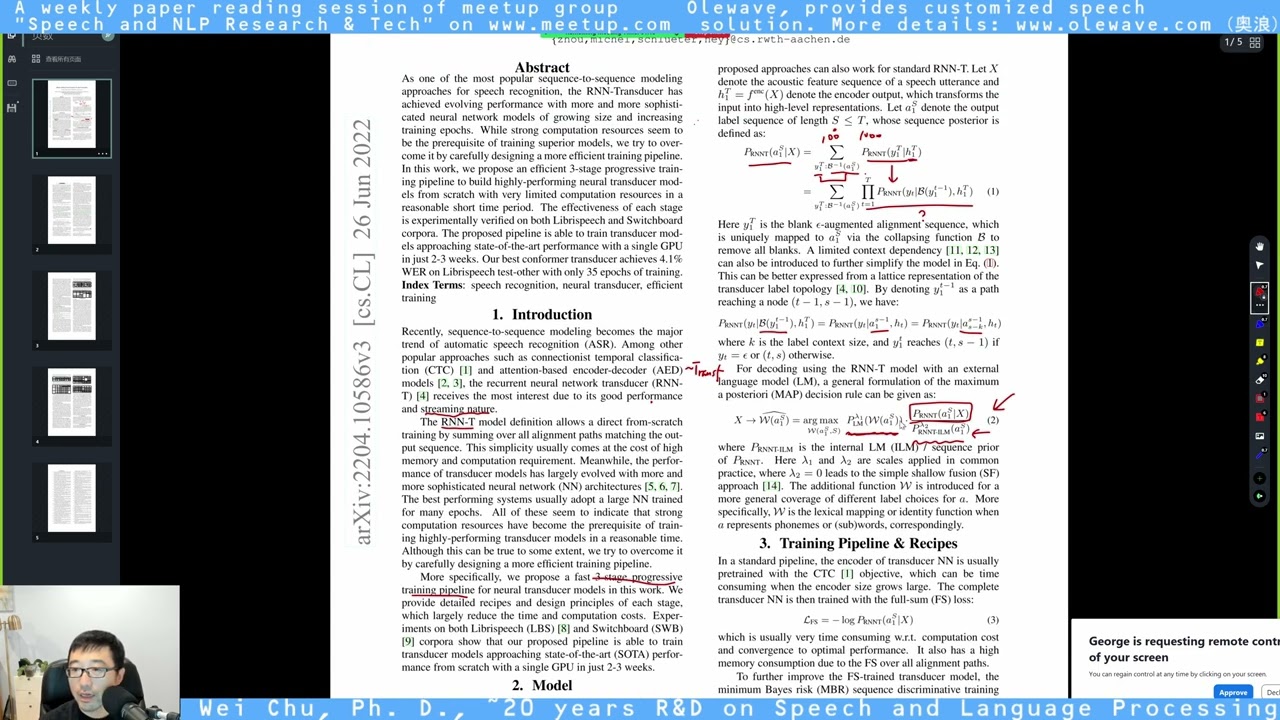
[Olewave의 롱 리뷰] 음성 인식을 위한 신경 트랜스듀서의 효율적인 훈련
신경 트랜스듀서는 스트리밍 ASR의 주력이지만, 효율적으로 훈련하는 것은 유명하게 고통스럽습니다: RNN-T 손실은 시퀀스 길이에서 3제곱 메모리를 가지며, 정렬 격자는 긴 발화에서 폭발하고, 단일-

[장문 리뷰] Conformer: 음성 인식을 위한 Convolution-augmented Transformer
Conformer는 end-to-end ASR을 조용히 장악한 모델이며, 모든 Transformer 블록에 convolution 모듈을 추가하는 그 방식은 단순하지만 놀랍게도 잘 작동하는 아이디어 중 하나입니다.

[긴 리뷰] Fully Sharded Data Parallel: 더 적은 GPU로 더 빠른 AI 학습
적당한 GPU 예산으로 수십억 매개변수 음성 또는 언어 모델을 학습하는 것은 파이프라인 병렬화, 텐서 병렬화, 또는 ZeRO 스타일의 옵티마이저 샤딩 중에서 선택해야 하는 것을 의미했습니다.
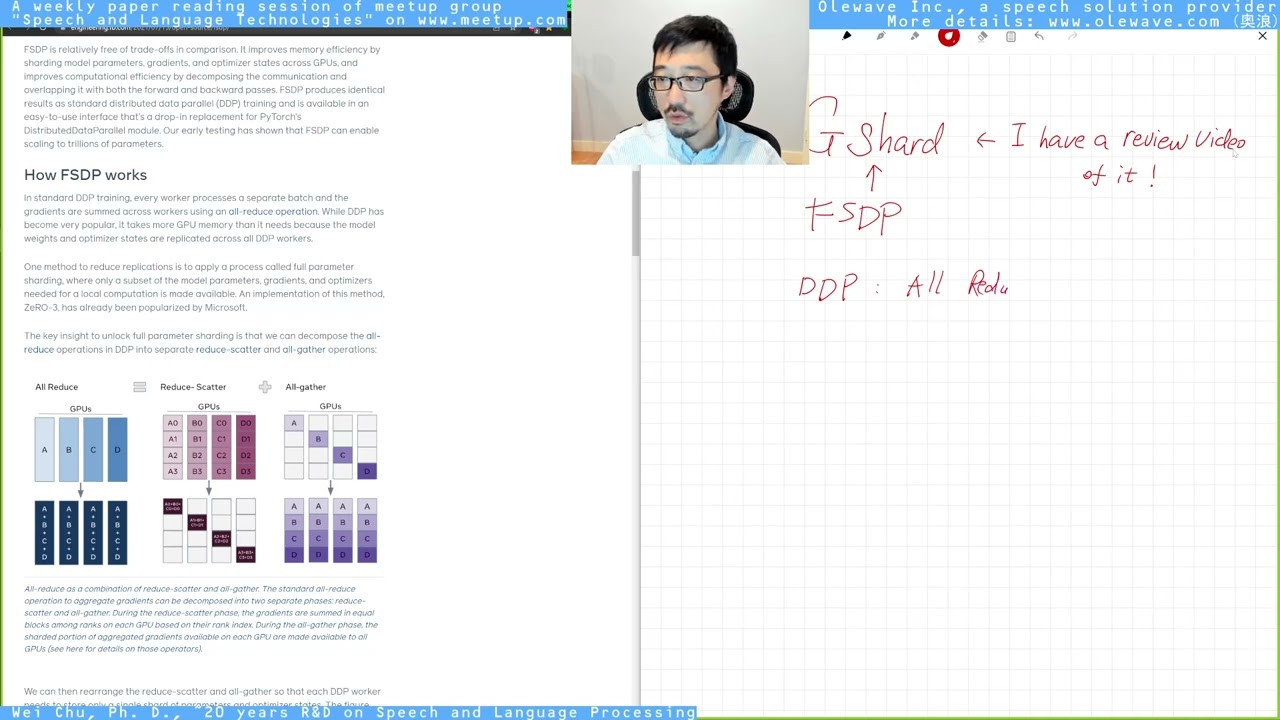
[짧은 리뷰] Fully Sharded Data Parallel: 더 적은 GPU로 더 빠른 AI 학습
Fully Sharded Data Parallel은 모든 음성 및 언어 팀이 결국 묻는 질문에 대한 Meta의 답변입니다: 더 큰 규모의 GPU를 프로비저닝하지 않고 한 자릿수 더 큰 모델을 학습하는 방법은 무엇일까요?
Breaking Bad에서 Wav2vec 2.0으로: 음성 표현의 자기 지도 학습을 위한 프레임워크
Walter White, Jesse Pinkman, 그리고 레이블이 없는 오디오 배치가 공통점이 뭘까요?
