


박사 아저씨가 컴퓨터로 2022 대입 수학 시험의 최종 문제를 풀다
연구용 컴퓨터 대수학 도구를 2022 중국 가오카오 수학 시험의 가장 어려운 문제에 사용하면 어떤 일이 일어날까요?

[장문 리뷰] Cascaded Diffusion Models for High Fidelity Image Generation
Imagen과 DALL-E 2가 생성 이미지를 위한 확산을 기본값으로 만들기 전에, 이 Google Brain 논문은 이후 많은 텍스트-이미지 시스템이 조용히 차용한 cascaded diffusion 레시피를 제시했습니다: 작은

[단문 리뷰] Cascaded Diffusion Models for High Fidelity Image Generation
Cascaded diffusion은 많은 최신 생성 작업의 기저를 이루는 다단계 레시피입니다: 한 개의 diffusion 모델로 작은 이미지를 생성한 후, 고주파 세부
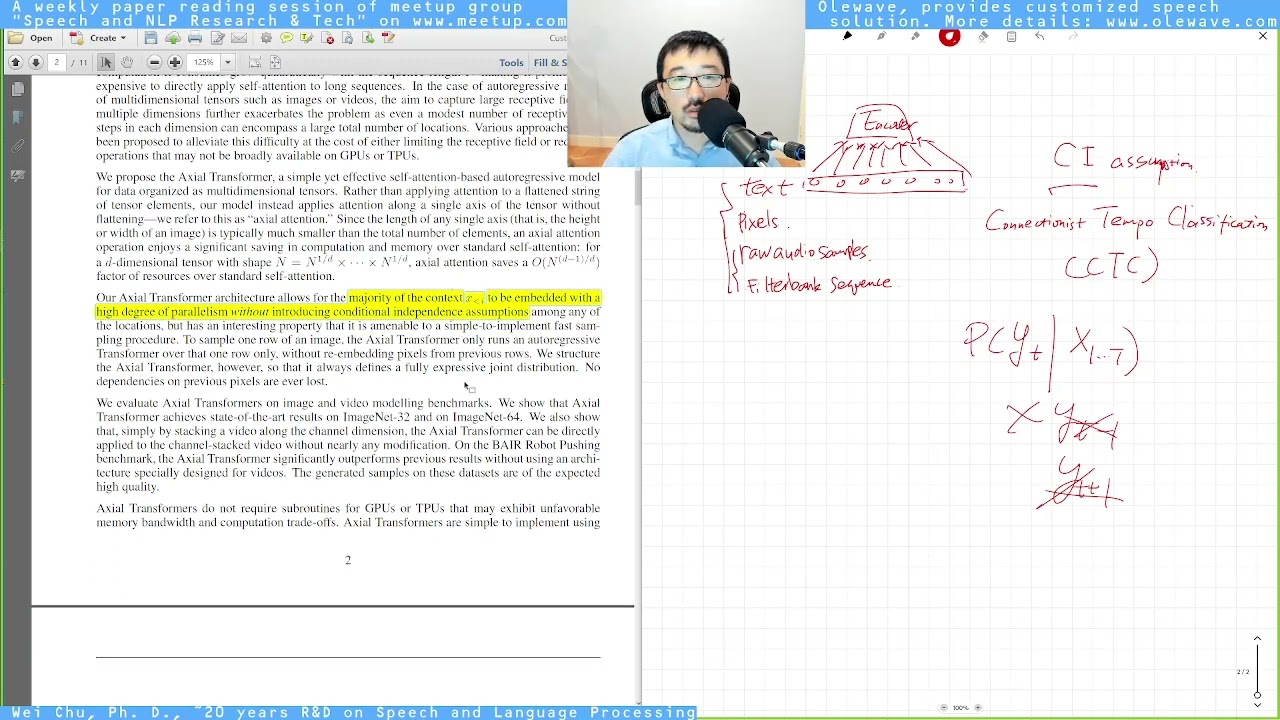
[장문 리뷰] Axial Attention in Multidimensional Transformers
이미지 또는 비디오에 대한 완전한 self-attention은 비용이 과도합니다. 이차 증가 없이 Transformer의 표현력을 유지하려면?
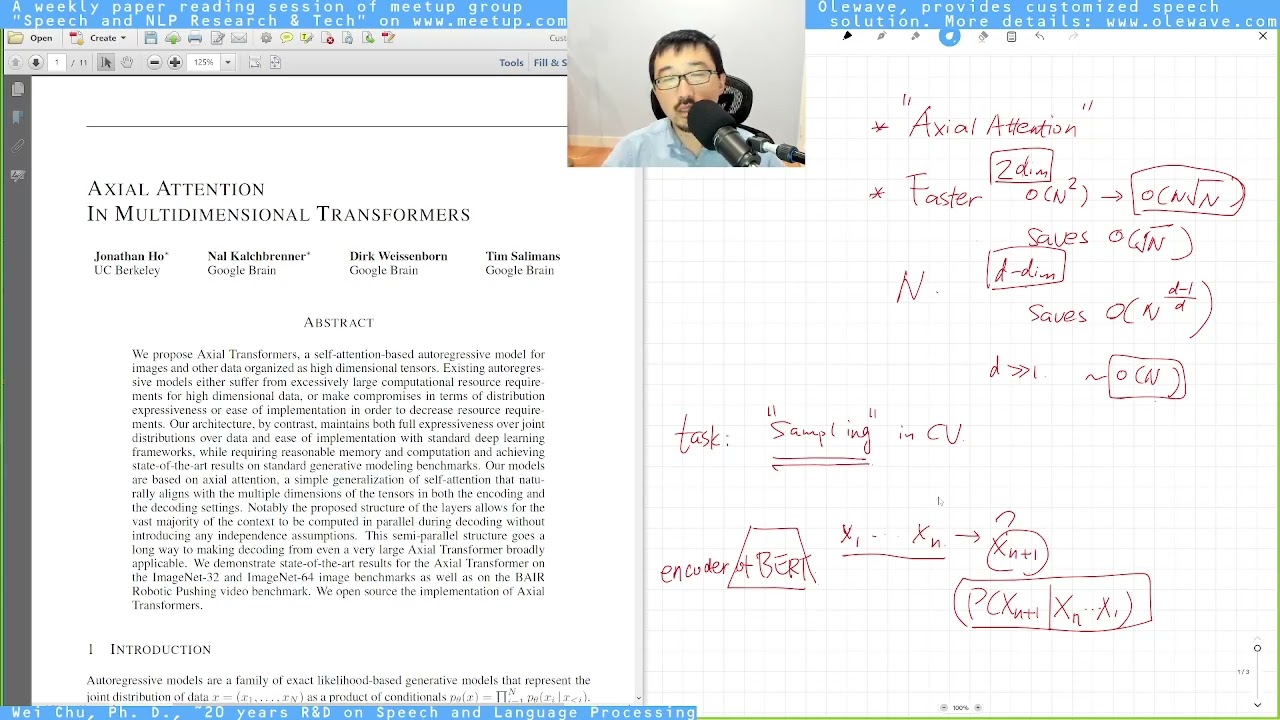
[단문 리뷰] Axial Attention in Multidimensional Transformers
Axial attention은 Transformer를 고차원 데이터에 대해 다루기 쉽게 유지하는 우아한 아이디어 중 하나입니다: 한 번에 모든 픽셀이나 모든 시간-주파수 빈에 주목하는 대신, 한 번에 한 축을 따라 주목합니다.

[롱 리뷰] Speaker Verification에서 Multispeaker Text-To-Speech Synthesis로의 Transfer Learning
이 논문은 제로샷 음성 클로닝을 실용적으로 만든 연구입니다: 수천 개의 노이즈가 많고 전사본이 없는 음성으로 판별적 검증 작업에서 speaker encoder를 학습한 후, 그 임베딩을 Tacotron 2로

[숏 리뷰] Speaker Verification에서 Multispeaker Text-To-Speech Synthesis로의 Transfer Learning
현대 제로샷 음성 클로닝 물결을 시작한 Google 논문은 아름답게 깔끔한 아키텍처를 가지고 있습니다: verification에 학습된 speaker encoder, 텍스트와 speaker 임베딩을

[롱 리뷰] Wav2Seq: Pseudo Languages를 사용한 Speech-to-Text Encoder-Decoder Models의 Pre-training
대부분의 speech pretraining은 encoder 측면에 집중했습니다: wav2vec, HuBERT, WavLM, 하지만 sequence-to-sequence ASR은 pretrained decoder도 필요합니다.

[숏 리뷰] Wav2Seq: Pseudo Languages를 사용한 Speech-to-Text Encoder-Decoder Models의 Pre-training
wav2vec 2.0 같은 Self-supervised pretraining은 훌륭한 speech encoder를 제공했습니다, 하지만 전체 encoder-decoder ASR 시스템을 원하면, decoder는 여전히 처음부터 시작했습니다.

[긴 리뷰] Towards Zero-Label Language Learning
인간이 레이블을 지정한 단 하나의 예제 없이 작업별 NLP 모델을 학습시킬 수 있다면 어떨까요? "Towards Zero-Label Language Learning"은 이 질문을 강하게 제기합니다.


[긴 리뷰] Fully Sharded Data Parallel: 더 적은 GPU로 더 빠른 AI 학습
적당한 GPU 예산으로 수십억 매개변수 음성 또는 언어 모델을 학습하는 것은 파이프라인 병렬화, 텐서 병렬화, 또는 ZeRO 스타일의 옵티마이저 샤딩 중에서 선택해야 하는 것을 의미했습니다.
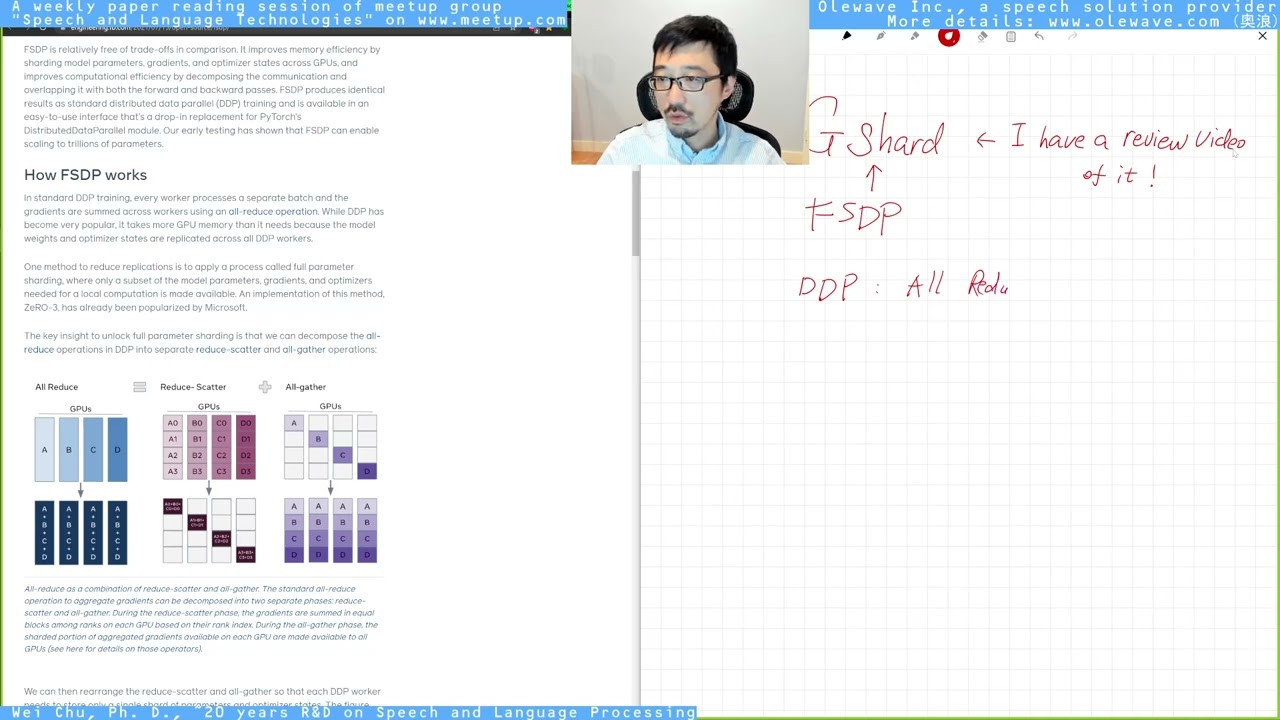
[짧은 리뷰] Fully Sharded Data Parallel: 더 적은 GPU로 더 빠른 AI 학습
Fully Sharded Data Parallel은 모든 음성 및 언어 팀이 결국 묻는 질문에 대한 Meta의 답변입니다: 더 큰 규모의 GPU를 프로비저닝하지 않고 한 자릿수 더 큰 모델을 학습하는 방법은 무엇일까요?

[Long Review] 훈련 데이터 중복 제거가 언어 모델을 더 좋게 만든다
중복 제거는 지루해 보이지만, C4 내에 61개 단어로 된 문장이 60,000번 이상 나타나고, 이런 말뭉치로 훈련된 언어 모델이 훈련 세트 텍스트를 불안하게 re

[Short Review] 훈련 데이터 중복 제거가 언어 모델을 더 좋게 만든다
당신의 언어 모델의 "일반화" 중 얼마나 많은 부분이 실제로는 단순한 반복일까요?

[Long Review] CLAS: 깊은 문맥: 종단간 문맥적 음성 인식
ASR 제품을 출시한 사람이라면 누구나 고유명사의 고통을 알고 있습니다: 연락처 이름, 노래 제목, 약물 이름, 모호한 장소 이름.


[긴 리뷰] 미세조정된 언어 모델은 제로샷 학습자
InstructGPT가 지시어 튜닝을 일상적인 표현으로 만들기 전에, Google의 FLAN 논문은 자연어 지시어에 대한 적당한 양의 다중 작업 미세조정이 평범한 LM을 놀랍도록 c

[긴 리뷰] 'GShard': 조건부 연산 및 자동 샤딩으로 거대 모델 확장
Transformer를 100억 개 이상의 매개변수로 확장하는 것은 빠르게 철학적이 됩니다: 모든 토큰에 대해 전체 네트워크를 활성화하거나 각 토큰을 실제로 봐야 하는 전문가에게 라우팅합니까?

세쌍둥이처럼 닮은 러시아 피겨 스케이터들: Kullback-Leibler 발산이 그들의 차이를 구별할 수 있습니까?
스피커 적응은 시퀀스-투-시퀀스 모델을 인코더의 어렵게 획득한 음향 표현을 손상시키지 않고 적응시키려고 실제로 시도할 때까지 해결된 것처럼 들리는 ASR 문제 중 하나입니다.

Nathan Chen의 4회전 플립이 Mixture-of-Experts로 채점됩니까? Part 1: Switch Transformers: 희소 MoE 모델
Nathan Chen의 4회전 점수에 대한 우스갯소리로 표현되는 이 토론은 Switch Transformer를 살펴봅니다. Google의 Mixture-of-Experts 확장에 대한 깔끔하고 과감하게 단순화된 해석입니다.
Nathan Chen의 4 Flip이 Mixture-of-Experts로 채점되나요? Part 2: GLaM:Efficient Scaling of LMs with MoE
MoE 미니 시리즈의 Part 2는 GLaM으로 초점을 맞춥니다. Google의 1.2조-파라미터 Mixture-of-Experts 언어 모델로, 제로-샷, 원-샷, 그리고 퓨-샷 벤치마크에서 GPT-3과 동등하거나 능가하며 토큰당 약 8%의 파라미터만 활성화합니다

음성 관점에서 검토된 BERT 논문
BERT는 NLP에서 거의 소개가 필요 없지만, 음성 엔지니어의 관점에서 읽으면 표준 "마스크된 언어 모델링이 모든 것을 바꿨다"는 요약과는 다른 교훈들을 발견합니다.
Transformer: Attention is All You Need와 Listen, Attend and Spell -- 음성 관점에서
두 편의 논문, 하나의 이야기. "Attention Is All You Need"는 세계에 Transformer를 제공하고 수열 모델링이 어떻게 수행되는지를 재설정했고, "Listen, Attend and Spell" (LAS)은 엔드-투-엔드 음성에 대해 1년 먼저 동일한 일을 했습…
Breaking Bad에서 Wav2vec 2.0으로: 음성 표현의 자기 지도 학습을 위한 프레임워크
Walter White, Jesse Pinkman, 그리고 레이블이 없는 오디오 배치가 공통점이 뭘까요?
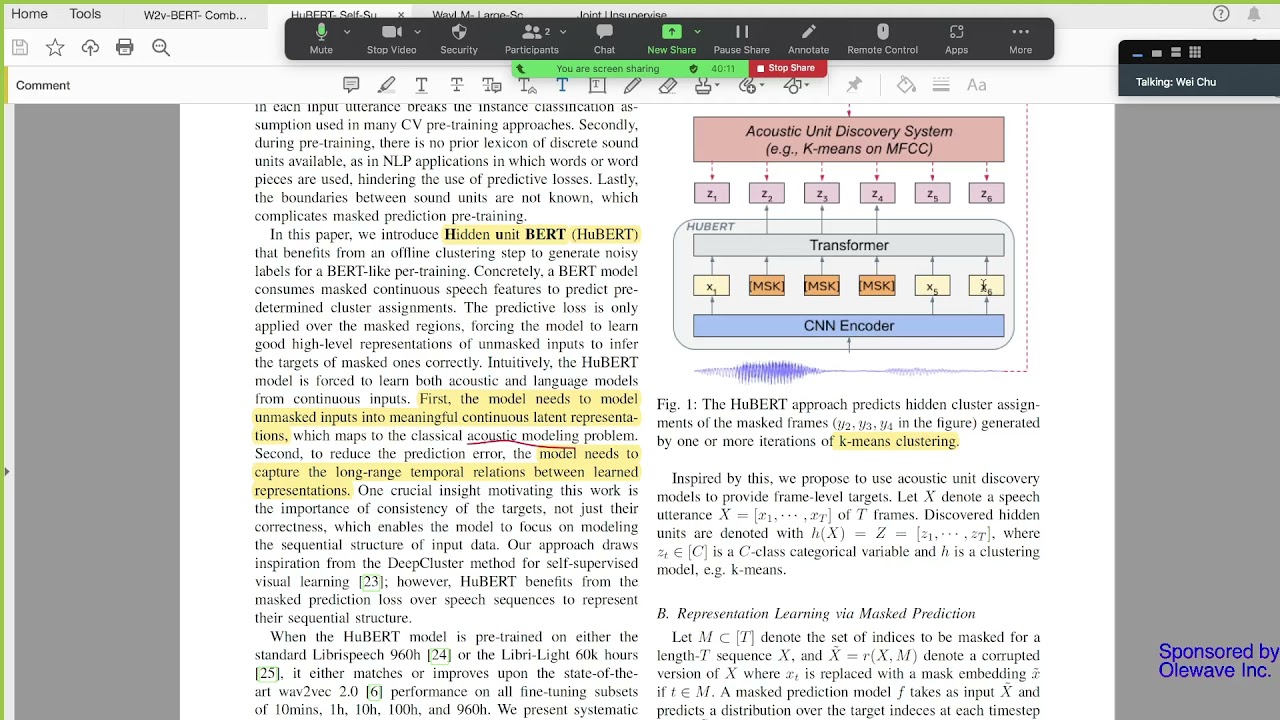
HuBERT: 숨겨진 단위의 마스킹 예측을 통한 자체 지도 음성 표현 학습
wav2vec 2.0이 대조적 자체 지도로 게임을 바꿨지만, HuBERT는 더 날카로운 질문을 제시했습니다: 대조적 트릭을 완전히 건너뛰고 음성에서 BERT 스타일의 마스킹 예측을 수행하면 어떨까요?
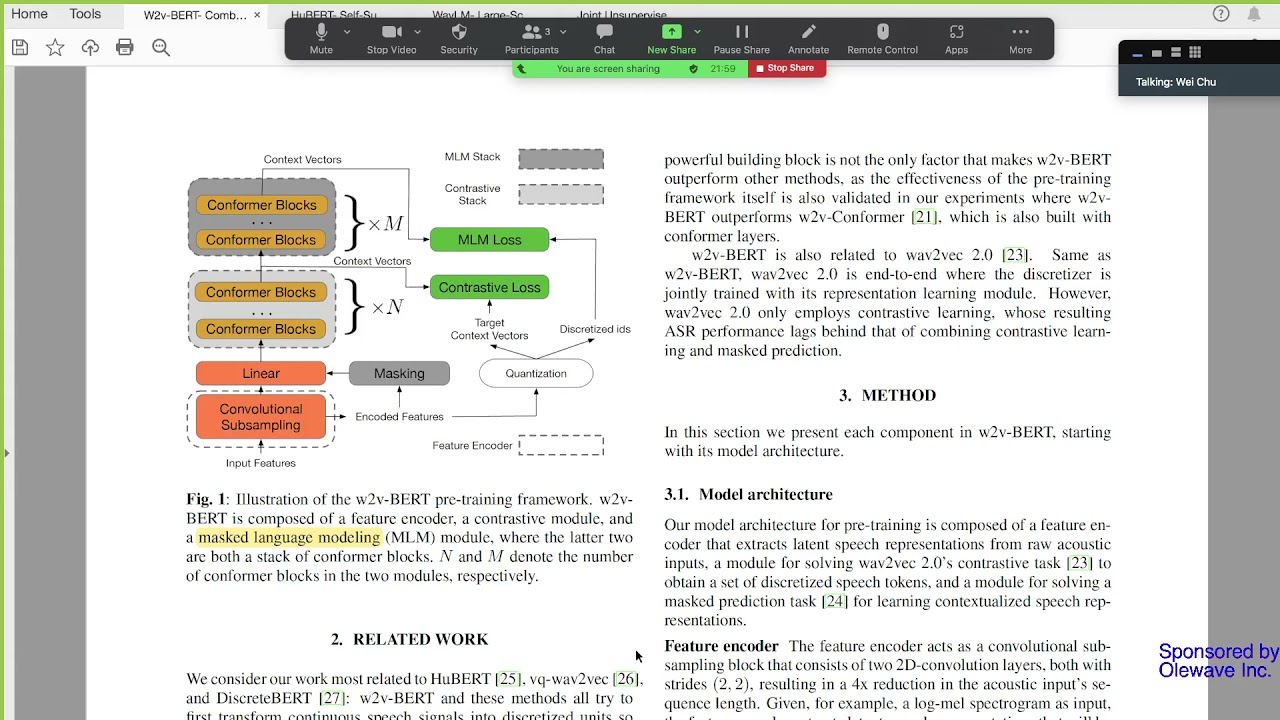
W2v-BERT: 대조 학습과 마스킹된 언어 모델링을 결합한 자체 지도
음성 사전 학습을 위해 대조 학습과 마스킹된 언어 모델링 중에 선택해야 할 때 둘을 같은 네트워크에 연결할 수 있다면 왜 선택해야 할까요?

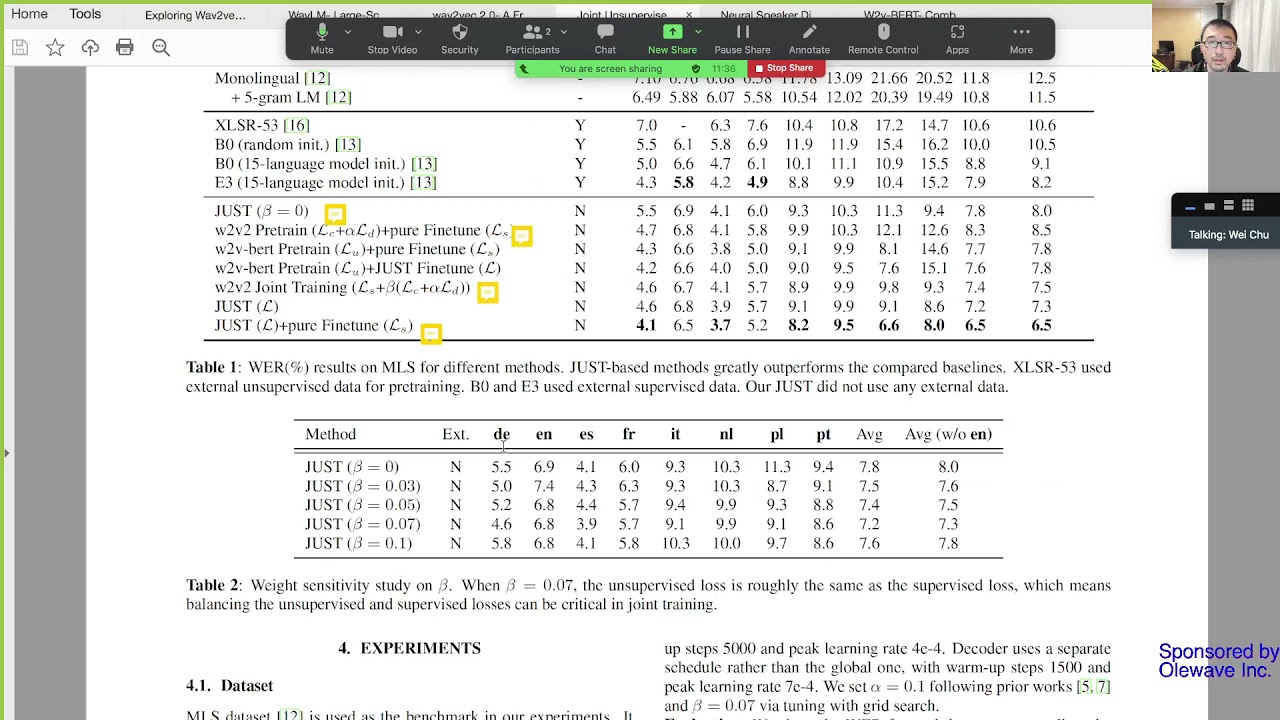
다국어 ASR을 위한 공동 비지도학습 및 지도학습 훈련
사전 훈련 후 미세 조정이 다국어 ASR의 기본 레시피가 되었지만, 많은 잠재력을 남기고 있습니다: 두 단계가 손실을 공유하지 않으며, 지도 단계가 유용한 자체 지도 구조를 조용히 제거할 수 있습니다
