


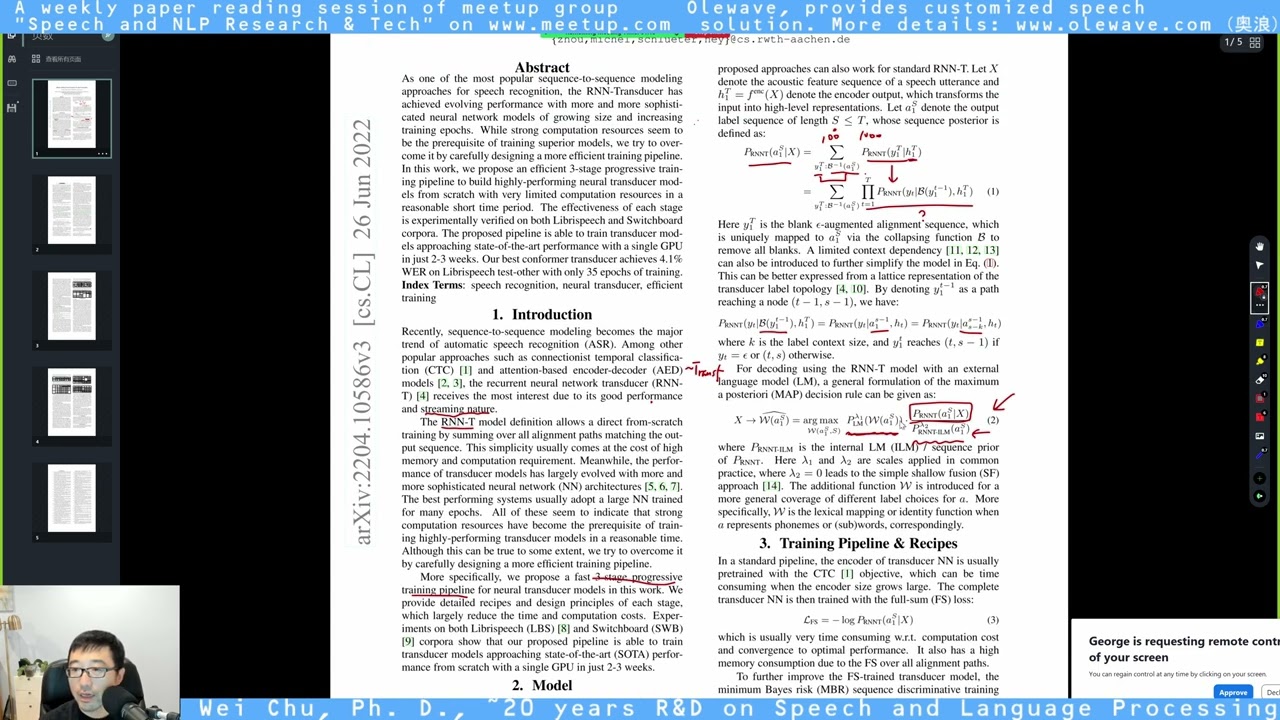
[Olewave의 롱 리뷰] 음성 인식을 위한 신경 트랜스듀서의 효율적인 훈련
신경 트랜스듀서는 스트리밍 ASR의 주력이지만, 효율적으로 훈련하는 것은 유명하게 고통스럽습니다: RNN-T 손실은 시퀀스 길이에서 3제곱 메모리를 가지며, 정렬 격자는 긴 발화에서 폭발하고, 단일-

Boris Johnson의 흥망 - 마이크의 분석
정치 뉴스는 보통 음성 AI 엔지니어가 금요일 오후에 큐에 올려놓는 것이 아니지만, Boris Johnson의 사임 발표는 일련의 스캔들에 대한 정당의 반란으로 마이크 뱅크 앞에서 전달되었습니다


iOS 16의 새로운 받아쓰기 기능은 어떻게 작동할까요? Apple의 비결을 음성 연구원이 밝혀줍니다!
Apple의 iOS 16 받아쓰기는 완전히 기기에서 실행되며, 이 단일 설계 선택은 지연 시간, 개인정보 보호, 그리고 휴대폰에서 실행 가능한 ASR 아키텍처의 종류에 대한 연쇄적 영향을 미칩니다.

[장문 리뷰] Conformer: 음성 인식을 위한 Convolution-augmented Transformer
Conformer는 end-to-end ASR을 조용히 장악한 모델이며, 모든 Transformer 블록에 convolution 모듈을 추가하는 그 방식은 단순하지만 놀랍게도 잘 작동하는 아이디어 중 하나입니다.
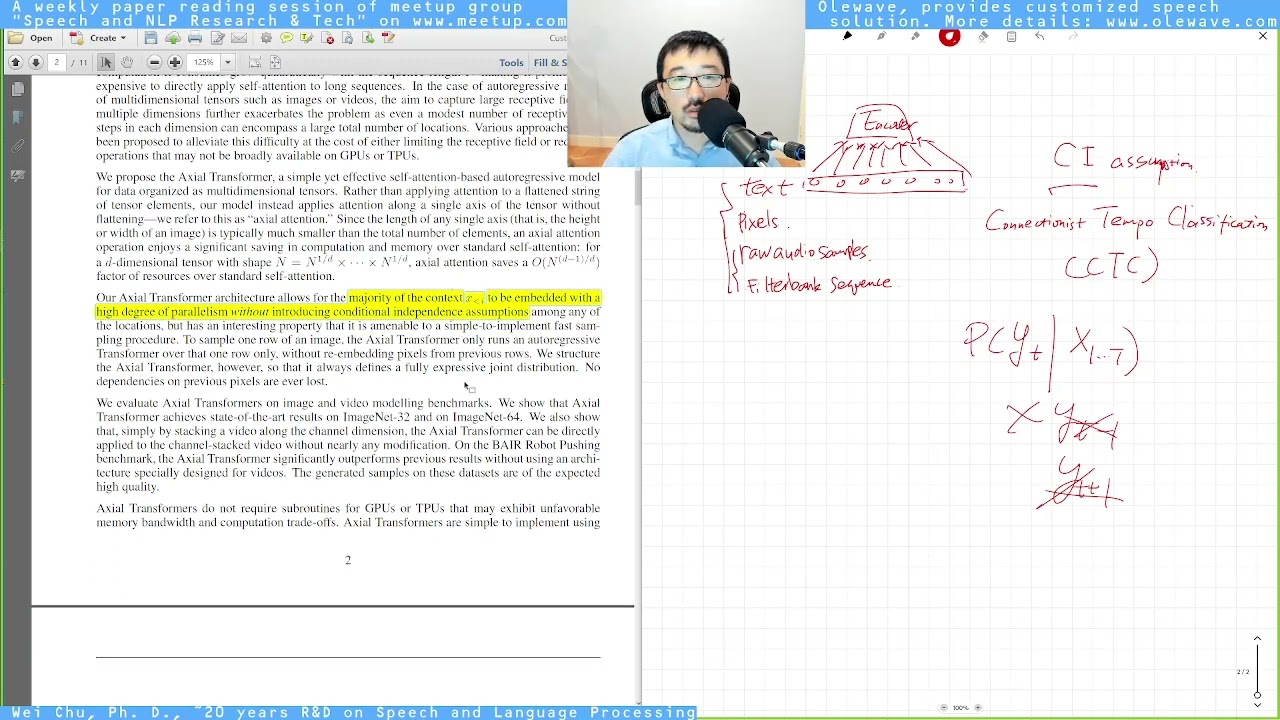
[장문 리뷰] Axial Attention in Multidimensional Transformers
이미지 또는 비디오에 대한 완전한 self-attention은 비용이 과도합니다. 이차 증가 없이 Transformer의 표현력을 유지하려면?
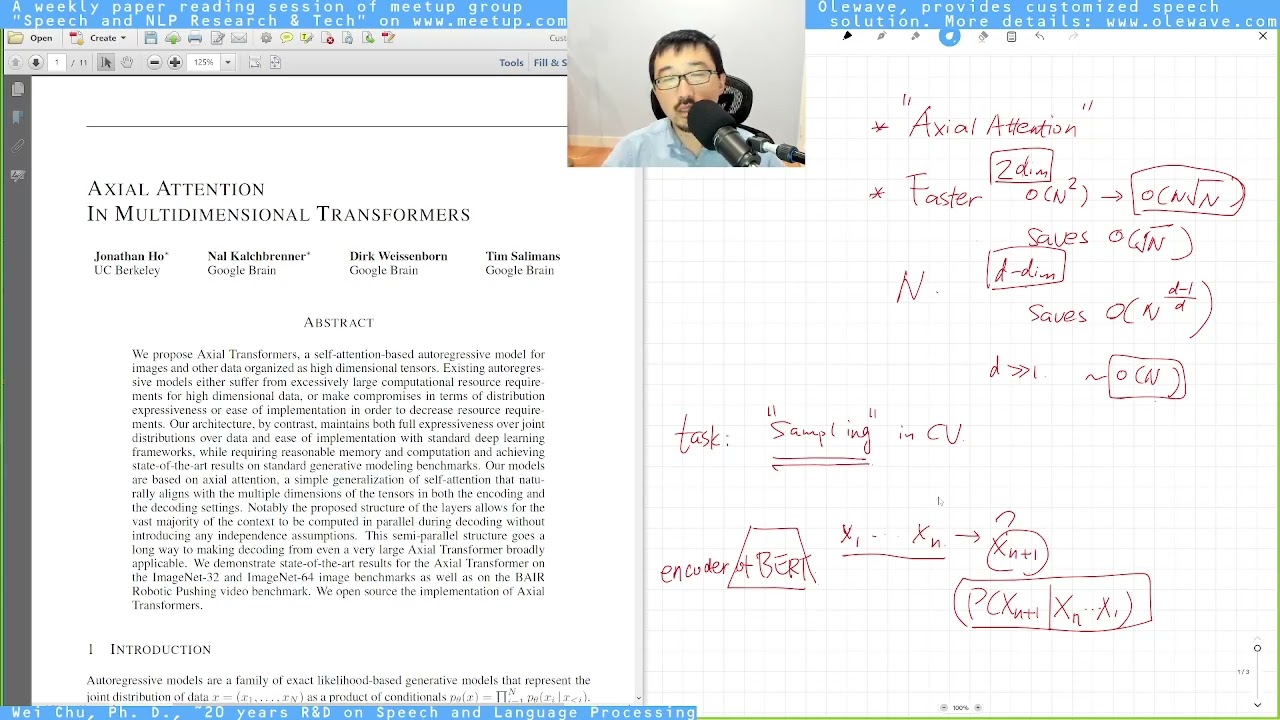
[단문 리뷰] Axial Attention in Multidimensional Transformers
Axial attention은 Transformer를 고차원 데이터에 대해 다루기 쉽게 유지하는 우아한 아이디어 중 하나입니다: 한 번에 모든 픽셀이나 모든 시간-주파수 빈에 주목하는 대신, 한 번에 한 축을 따라 주목합니다.

[롱 리뷰] Speaker Verification에서 Multispeaker Text-To-Speech Synthesis로의 Transfer Learning
이 논문은 제로샷 음성 클로닝을 실용적으로 만든 연구입니다: 수천 개의 노이즈가 많고 전사본이 없는 음성으로 판별적 검증 작업에서 speaker encoder를 학습한 후, 그 임베딩을 Tacotron 2로

[숏 리뷰] Speaker Verification에서 Multispeaker Text-To-Speech Synthesis로의 Transfer Learning
현대 제로샷 음성 클로닝 물결을 시작한 Google 논문은 아름답게 깔끔한 아키텍처를 가지고 있습니다: verification에 학습된 speaker encoder, 텍스트와 speaker 임베딩을

[숏 리뷰] Wav2Seq: Pseudo Languages를 사용한 Speech-to-Text Encoder-Decoder Models의 Pre-training
wav2vec 2.0 같은 Self-supervised pretraining은 훌륭한 speech encoder를 제공했습니다, 하지만 전체 encoder-decoder ASR 시스템을 원하면, decoder는 여전히 처음부터 시작했습니다.

[긴 리뷰] Towards Zero-Label Language Learning
인간이 레이블을 지정한 단 하나의 예제 없이 작업별 NLP 모델을 학습시킬 수 있다면 어떨까요? "Towards Zero-Label Language Learning"은 이 질문을 강하게 제기합니다.

[긴 리뷰] Fully Sharded Data Parallel: 더 적은 GPU로 더 빠른 AI 학습
적당한 GPU 예산으로 수십억 매개변수 음성 또는 언어 모델을 학습하는 것은 파이프라인 병렬화, 텐서 병렬화, 또는 ZeRO 스타일의 옵티마이저 샤딩 중에서 선택해야 하는 것을 의미했습니다.
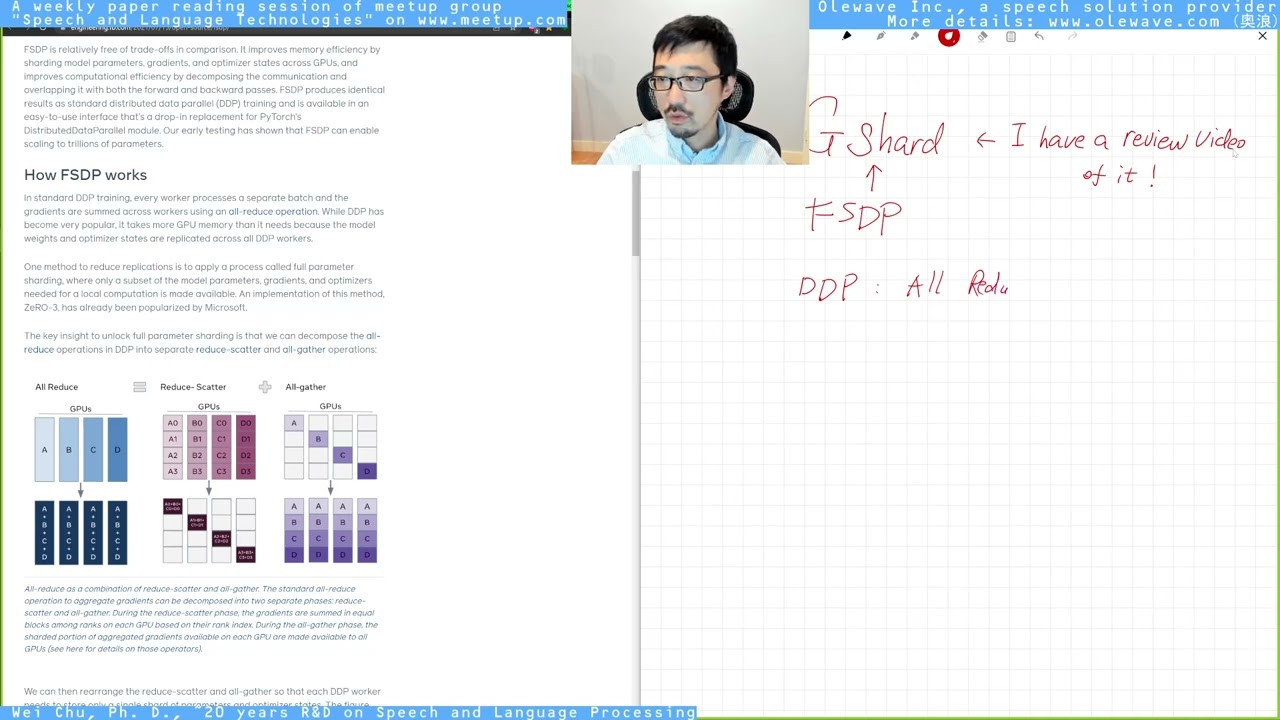
[짧은 리뷰] Fully Sharded Data Parallel: 더 적은 GPU로 더 빠른 AI 학습
Fully Sharded Data Parallel은 모든 음성 및 언어 팀이 결국 묻는 질문에 대한 Meta의 답변입니다: 더 큰 규모의 GPU를 프로비저닝하지 않고 한 자릿수 더 큰 모델을 학습하는 방법은 무엇일까요?

[Short Review] 훈련 데이터 중복 제거가 언어 모델을 더 좋게 만든다
당신의 언어 모델의 "일반화" 중 얼마나 많은 부분이 실제로는 단순한 반복일까요?


[긴 리뷰] 미세조정된 언어 모델은 제로샷 학습자
InstructGPT가 지시어 튜닝을 일상적인 표현으로 만들기 전에, Google의 FLAN 논문은 자연어 지시어에 대한 적당한 양의 다중 작업 미세조정이 평범한 LM을 놀랍도록 c

[긴 리뷰] 'GShard': 조건부 연산 및 자동 샤딩으로 거대 모델 확장
Transformer를 100억 개 이상의 매개변수로 확장하는 것은 빠르게 철학적이 됩니다: 모든 토큰에 대해 전체 네트워크를 활성화하거나 각 토큰을 실제로 봐야 하는 전문가에게 라우팅합니까?

세쌍둥이처럼 닮은 러시아 피겨 스케이터들: Kullback-Leibler 발산이 그들의 차이를 구별할 수 있습니까?
스피커 적응은 시퀀스-투-시퀀스 모델을 인코더의 어렵게 획득한 음향 표현을 손상시키지 않고 적응시키려고 실제로 시도할 때까지 해결된 것처럼 들리는 ASR 문제 중 하나입니다.

Nathan Chen의 4회전 플립이 Mixture-of-Experts로 채점됩니까? Part 1: Switch Transformers: 희소 MoE 모델
Nathan Chen의 4회전 점수에 대한 우스갯소리로 표현되는 이 토론은 Switch Transformer를 살펴봅니다. Google의 Mixture-of-Experts 확장에 대한 깔끔하고 과감하게 단순화된 해석입니다.
Nathan Chen의 4 Flip이 Mixture-of-Experts로 채점되나요? Part 2: GLaM:Efficient Scaling of LMs with MoE
MoE 미니 시리즈의 Part 2는 GLaM으로 초점을 맞춥니다. Google의 1.2조-파라미터 Mixture-of-Experts 언어 모델로, 제로-샷, 원-샷, 그리고 퓨-샷 벤치마크에서 GPT-3과 동등하거나 능가하며 토큰당 약 8%의 파라미터만 활성화합니다

음성 관점에서 검토된 BERT 논문
BERT는 NLP에서 거의 소개가 필요 없지만, 음성 엔지니어의 관점에서 읽으면 표준 "마스크된 언어 모델링이 모든 것을 바꿨다"는 요약과는 다른 교훈들을 발견합니다.
Transformer: Attention is All You Need와 Listen, Attend and Spell -- 음성 관점에서
두 편의 논문, 하나의 이야기. "Attention Is All You Need"는 세계에 Transformer를 제공하고 수열 모델링이 어떻게 수행되는지를 재설정했고, "Listen, Attend and Spell" (LAS)은 엔드-투-엔드 음성에 대해 1년 먼저 동일한 일을 했습…
Breaking Bad에서 Wav2vec 2.0으로: 음성 표현의 자기 지도 학습을 위한 프레임워크
Walter White, Jesse Pinkman, 그리고 레이블이 없는 오디오 배치가 공통점이 뭘까요?
