


Tutorials
用於語音增強和識別聯合訓練的SNRi目標訓練
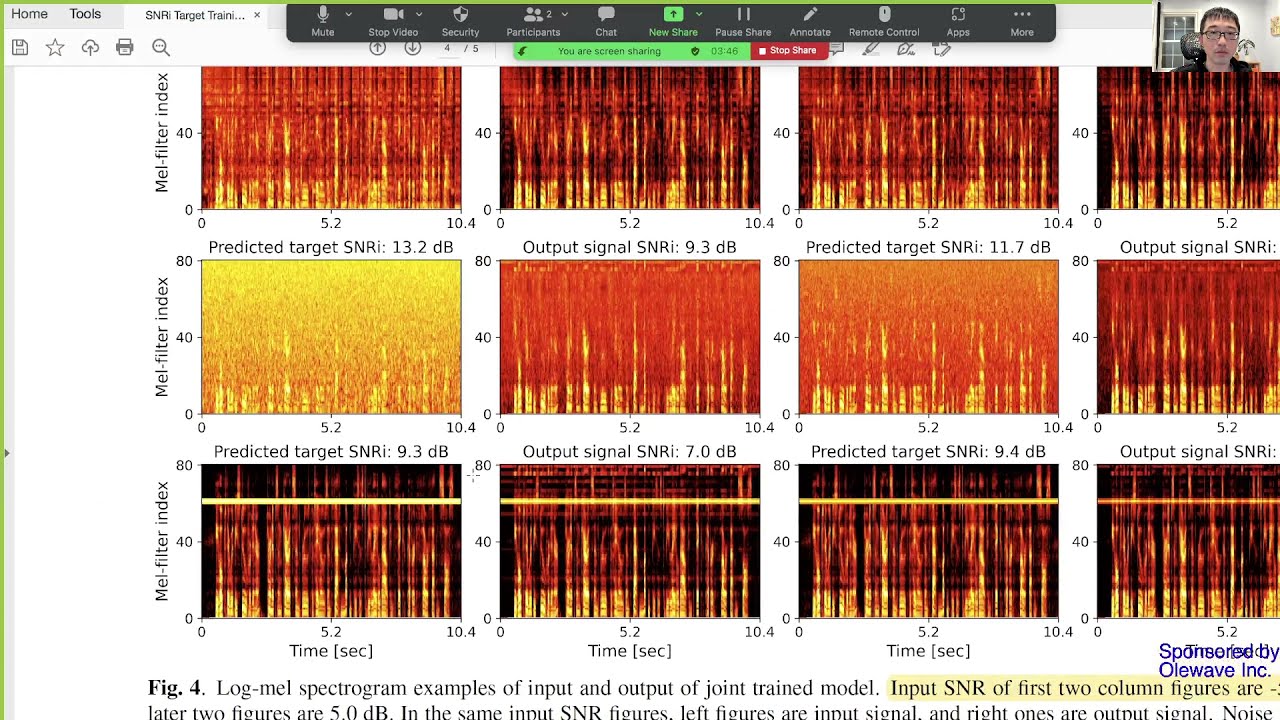
語音增強和ASR的聯合訓練聽起來很簡單——只需通過去噪器反向傳播識別損失——但實踐中很混亂,因為激進的去噪往往會扭曲聲學模型所依賴的特徵
語音增強和ASR的聯合訓練聽起來很簡單——只需通過去噪器反向傳播識別損失——但實踐中很混亂,因為激進的去噪往往會扭曲聲學模型所依賴的特徵