

是什麼讓Olewave的語音資料清理管道有效且獨特
Olewave 的 Olign 管線如何在無需人工標註員的情況下,將原始音訊轉換為可直接用於生產環境的 ASR/TTS 訓練資料,並附上經過驗證的逐字稿、字詞層級時間戳記與信心分數。
Olewave 最先進、高度可客製化的語音資料清理管線可與語音資料收集管線無縫整合,兩者共同組成Olewave 的語音資料策展管線。這套端到端系統經過精心設計,可大規模提供高品質、一致性佳且具成本效益的語音資料集。這些資料集專為各種下游應用量身打造。此外,我們也提供透過我們的管線策展而成的大規模且具成本效益的語音資料集,備有多種語言,涵蓋多元主題。
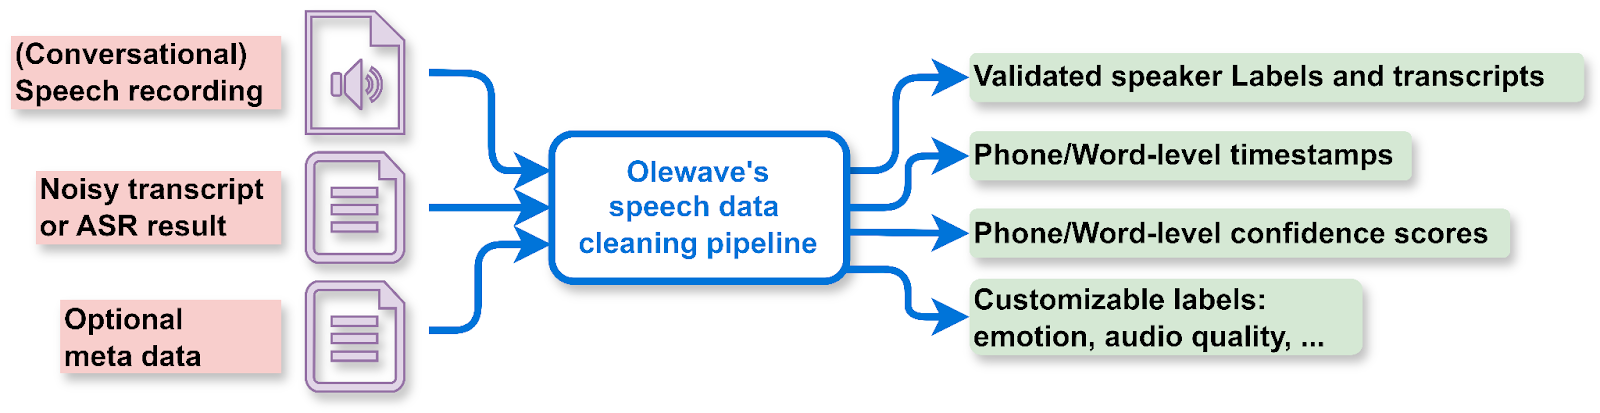
下圖呈現我們語音資料清理管線的精簡工作流程,展現它能將原始、非結構化的語音資料轉換為精緻、可直接運用的資料集。
我們的管線具備多項優勢。
- 有效。與 Whisper 及其他開源工具相比,它能產生經過驗證的說話者標籤與轉錄結果、準確的字詞時間戳記,以及不會過度自信的信心分數。
- 穩健。它能處理即興的對話語音,包括說話者重疊的情境,以及含有 ASR 錯誤的逐字稿。
- 可擴充。它可運用選用的中繼資料,也能升級以納入額外的模態,提高標籤的可靠度。這條管線也支援以隨插即用的方式整合 Olewave 或客戶自有的各種標籤標註模型(例如情緒、語意等)。
- 高效。它運行迅速且具成本效益,因為不需要或只需要少量 GPU 資源。
此外,如果你的目標是讓人工標註員修正自動語音辨識(ASR)的結果,我們管線的輸出可以從兩方面大幅降低標註成本。
- 以準確的時間資訊精準標示字詞,讓標註員能快速找到並檢視含糊或不清楚的片段,不必反覆聆聽整段音訊。
- 引導標註員專注於信心分數落在中間範圍的字詞,減少逐字檢視的需要,並簡化修正流程。
透過這些具針對性的資訊,我們的管線能提升效率,減少人工作業,並確保標註工作流程更具成本效益。
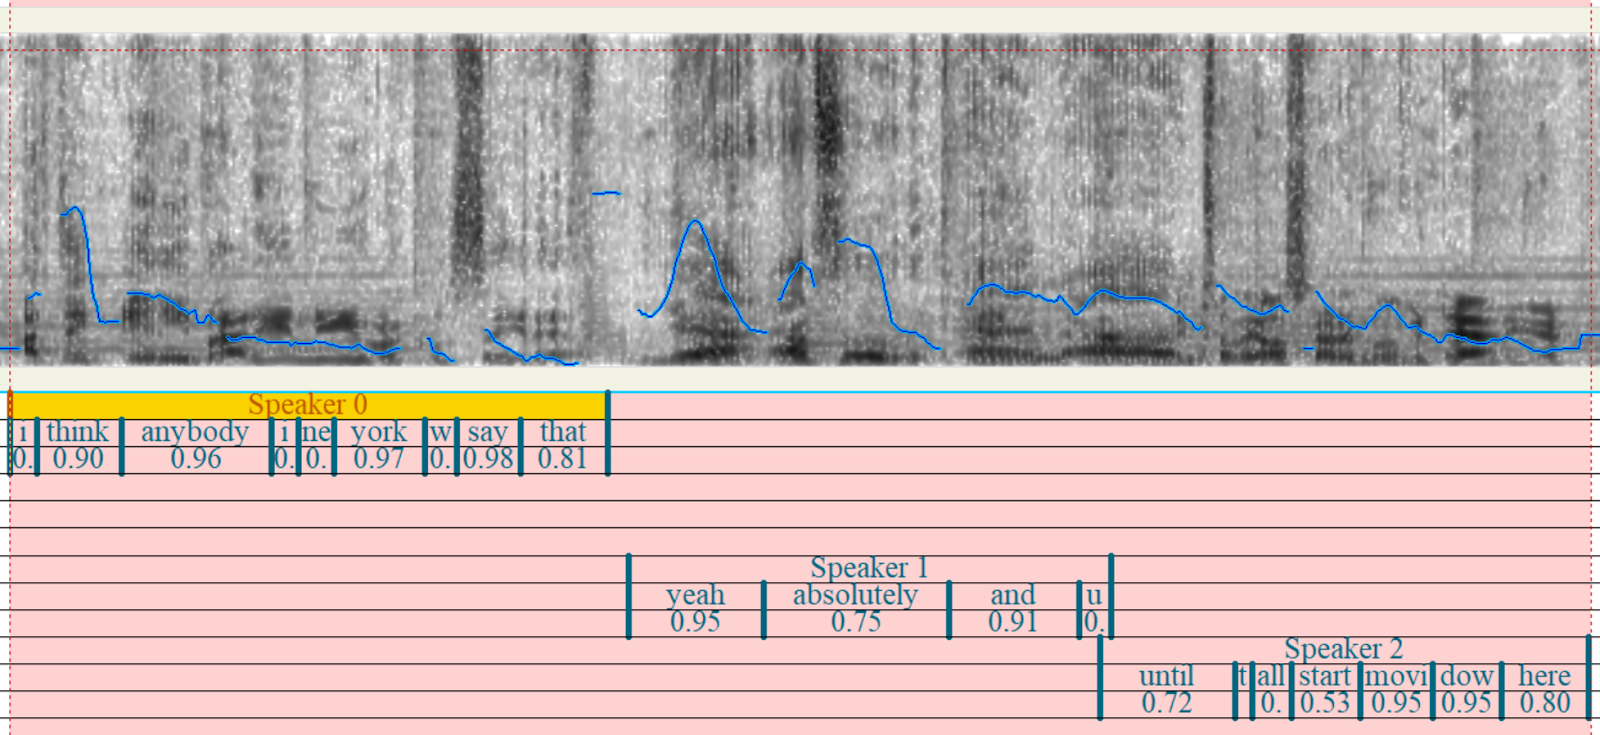
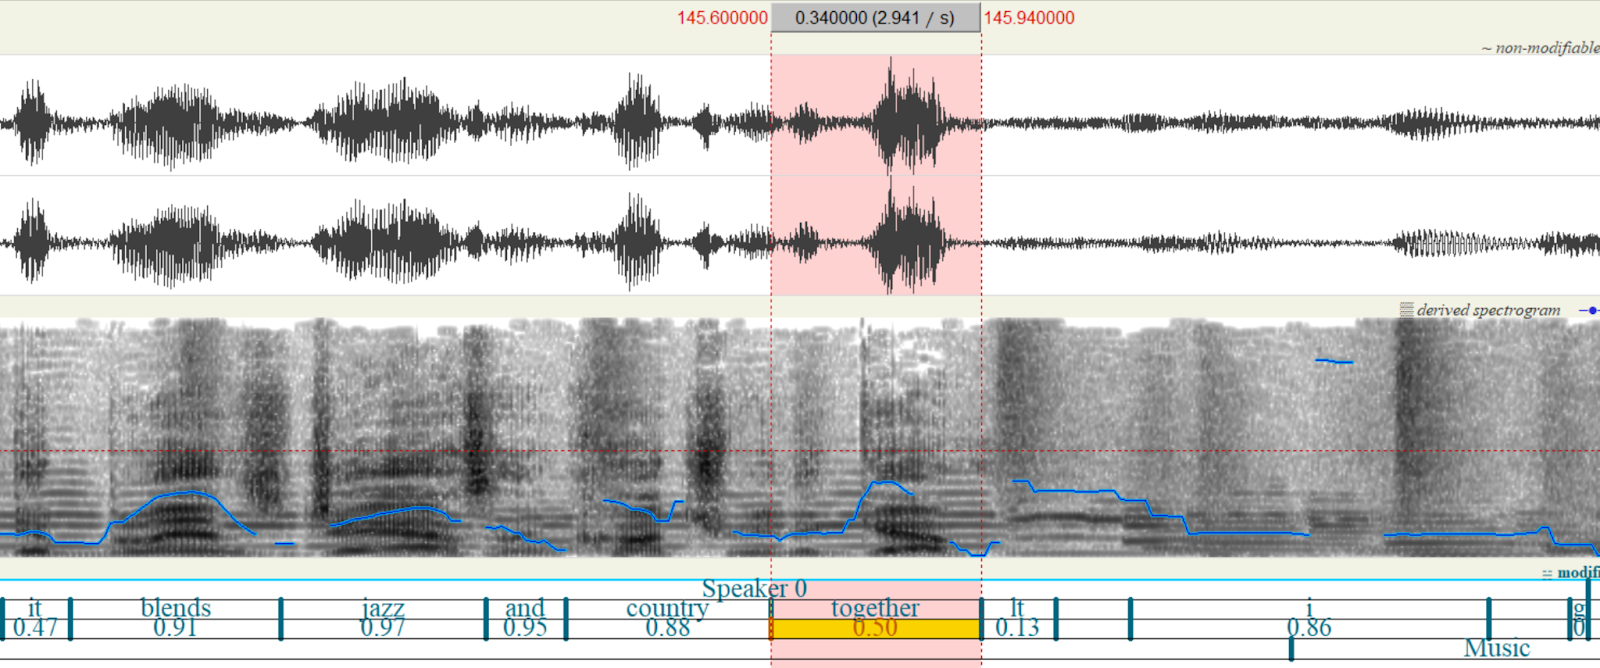
以下是管線輸出的視覺化範例,呈現說話者標籤、字詞層級時間戳記與信心分數。
學術界與業界普遍認為,大型端到端(E2E)框架與大型 E2E ASR 模型在產生準確的字詞層級時間戳記與可靠的字詞層級信心分數方面,分別存在固有限制。
為了解決這些限制,我們善用在非端到端的語音與文字對齊技術方面的深厚專業,並開發出納入中繼資料的精密處理程序。這種做法讓我們能有效清除逐字稿中的非口語內容(例如贅詞、背景噪音的轉錄內容),確保最終輸出具備更高的準確度與可靠度。
以下是資料管線輸出的字詞層級 JSON 片段。「speaker」欄位表示這段錄音中說話者的編號。「start_time」與「end_time」欄位以秒為單位,表示說話者發言的時間範圍。「block」欄位包含同一位說話者的一段或多段連續語句。每段語句都有各自的開始時間、結束時間、逐字稿、說話者重疊指標與信心分數。當「overlap」欄位為 true 時,表示目前的片段與相鄰片段有說話者重疊。信心分數的範圍是 0 到 1。
{
        "speaker": 0,
        "start_time": "47.18",
        "end_time": "49.83",
        "block": [
            {
                "start_time": "47.18",
                "end_time": "49.83",
                "transcript": "music-related jobs compared to New York and LA.",
                "overlap": false,
                "word_details": [
                    {
                        "start_time": "47.18",
                        "end_time": "47.53",
                        "word": "music",
                        "confidence": "0.97"
                    },
                    {
                        "start_time": "47.53",
                        "end_time": "47.89",
                        "word": "related",
                        "confidence": "0.79"
                    },
                    {
                        "start_time": "47.89",
                        "end_time": "48.44",
                        "word": "jobs",
                        "confidence": "0.98"
                    },
                    {
                        "start_time": "48.44",
                        "end_time": "48.90",
                        "word": "compared",
                        "confidence": "0.96"
                    },
                    {
                        "start_time": "48.90",
                        "end_time": "48.96",
                        "word": "to",
                        "confidence": "0.17"
                    },
                    {
                        "start_time": "48.96",
                        "end_time": "49.08",
                        "word": "new",
                        "confidence": "0.97"
                    },
                    {
                        "start_time": "49.08",
                        "end_time": "49.37",
                        "word": "york",
                        "confidence": "0.98"
                    },
                    {
                        "start_time": "49.37",
                        "end_time": "49.49",
                        "word": "and",
                        "confidence": "0.92"
                    },
                    {
                        "start_time": "49.49",
                        "end_time": "49.83",
                        "word": "la",
                        "confidence": "0.56"
                    }
                ]
            }
        ]
    },