


Olign 1.1 推出,詞時間戳記更準確
在 FA-Bench 的每個測試集上,無論是乾淨音訊還是噪音環境,Olign 1.1 給出的詞時間都比 Olign 1.0 更準確。你現有的請求不需修改就能繼續使用。
FA-Bench 排行榜 · github.com/olewave/fa-bench
Olign 1.1 已在 Olign API 上線。在我們測量的每個測試集上,無論乾淨還是加噪,它給出的詞時間都比 Olign 1.0 更準確。
詞的時間一旦不準,人們馬上就會察覺。字幕應在說話者開口時出現,在說完時消失。配音會在停頓處把語音切成一句句台詞,所以每個停頓都必須落在它真實的位置。語言學習 App 應該在每個詞被唸出的那一刻點亮它。這些都取決於百分之幾秒的差別。
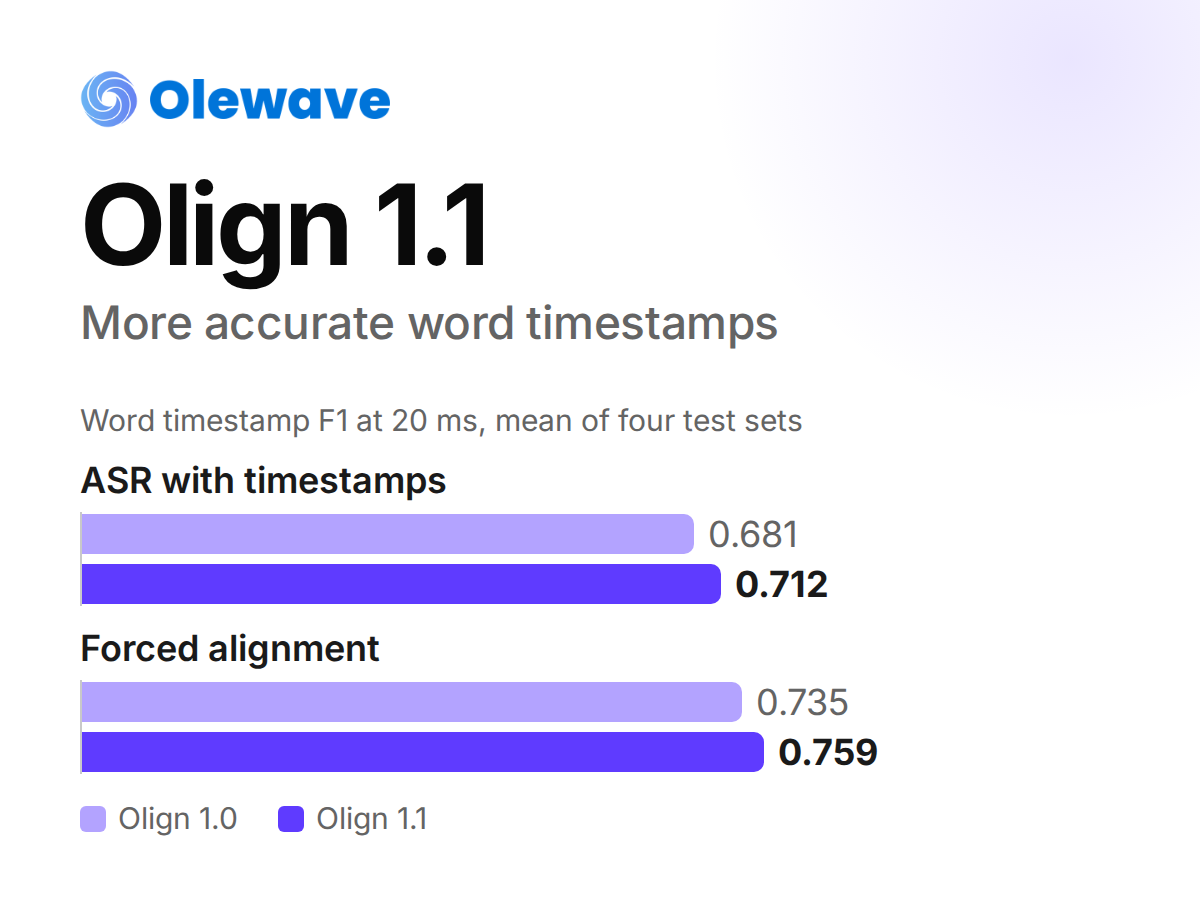
Olign 1.1 讓詞的時間更貼近語音本身,停頓現在也會以接近真實長度的形式回傳。依 FA-Bench 四個測試集的平均值,20 ms 詞時間戳記 F1 在只有音訊時從 0.681 提升到 0.712,在附帶逐字稿時從 0.735 提升到 0.759。你現有的請求不需修改就能繼續使用。
測量方法
我們比較了 2026 年 11 月在正式服務上測量的 Olign 1.1.3 版,以及 2026 年 10 月測量的 Olign 1.0。兩者在相同的測試集上執行,並由同一個公開的 FA-Bench 評分器評分。
FA-Bench 使用兩個英語語料庫,它們的詞邊界和音素邊界都由人工標註。TIMIT core test 是朗讀語音,Buckeye test 是對話語音。每個語料庫都會以乾淨音訊執行,也會分別加入殘響、噪音、音樂和多人交談聲後執行。下文的「加噪」是這四種情況的平均值。這樣一共是四個測試集,「四項平均」就是它們的平均值。
測試分成兩個賽道。帶時間戳記的 ASR 只拿到音訊,Olign 回傳自己辨識出的詞和它們的時間。強制對齊還會拿到逐字稿。
20 ms 詞時間戳記 F1 衡量詞的起始時間和結束時間中,有多少比例落在人工標註的 20 ms 以內,它綜合了精確率和召回率。越高越好。
詞錯誤率 計算被替換、遺漏或多出的詞,並以它們占實際所說詞數的比例表示。越低越好。
詞邊界誤差 是 Olign 的詞邊界與人工標註邊界之間的平均距離,單位為毫秒。越低越好。
20 ms 音素邊界 F1 與詞時間戳記 F1 是同一個指標,只是用在音與音之間的邊界上。
Olewave 同時開發 FA-Bench 和 Olign。因此,Olign 在 FA-Bench 排行榜上以未排名的形式列在表格底部。本文把 FA-Bench 當作一把公開、可重現的尺來使用,不做任何排名。
帶時間戳記的 ASR
你只傳送音訊。
詞時間戳記 F1 在全部四個測試集上都有提升。提升最大的是乾淨的 Buckeye,從 0.660 升到 0.702。詞錯誤率幾乎沒有變化,平均從 7.5% 變為 7.4%。所以提升來自時間的準確度。
全部數字
| TIMIT 乾淨 | TIMIT 加噪 | Buckeye 乾淨 | Buckeye 加噪 | 四項平均 | |
|---|---|---|---|---|---|
| 詞時間戳記 F1,Olign 1.0 | 0.786 | 0.695 | 0.660 | 0.585 | 0.681 |
| 詞時間戳記 F1,Olign 1.1 | 0.804 | 0.726 | 0.702 | 0.615 | 0.712 |
| 詞錯誤率,Olign 1.0 | 2.2% | 3.2% | 10.2% | 14.3% | 7.5% |
| 詞錯誤率,Olign 1.1 | 2.2% | 3.2% | 9.9% | 14.2% | 7.4% |
強制對齊
你傳送音訊和對應的逐字稿。
詞時間戳記 F1 在全部四個測試集上都有提升,詞邊界誤差在四個測試集上都有下降。詞邊界誤差下降最多的是加噪的 TIMIT,從 33.0 ms 降到 25.7 ms。音素邊界 F1 在各處都略有提升,平均從 0.452 升到 0.458。大部分變化發生在詞的邊緣。
全部數字
| TIMIT 乾淨 | TIMIT 加噪 | Buckeye 乾淨 | Buckeye 加噪 | 四項平均 | |
|---|---|---|---|---|---|
| 詞時間戳記 F1,Olign 1.0 | 0.805 | 0.710 | 0.755 | 0.668 | 0.735 |
| 詞時間戳記 F1,Olign 1.1 | 0.824 | 0.747 | 0.775 | 0.689 | 0.759 |
| 詞邊界誤差,Olign 1.0 | 18.2 ms | 33.0 ms | 22.4 ms | 43.8 ms | |
| 詞邊界誤差,Olign 1.1 | 17.0 ms | 25.7 ms | 18.7 ms | 38.8 ms | |
| 音素邊界 F1,Olign 1.0 | 0.410 | 0.393 | 0.523 | 0.483 | 0.452 |
| 音素邊界 F1,Olign 1.1 | 0.413 | 0.396 | 0.529 | 0.492 | 0.458 |
有哪些變化
Olign 的發布版本和 API 各有自己的版本號。下文會分別註明。
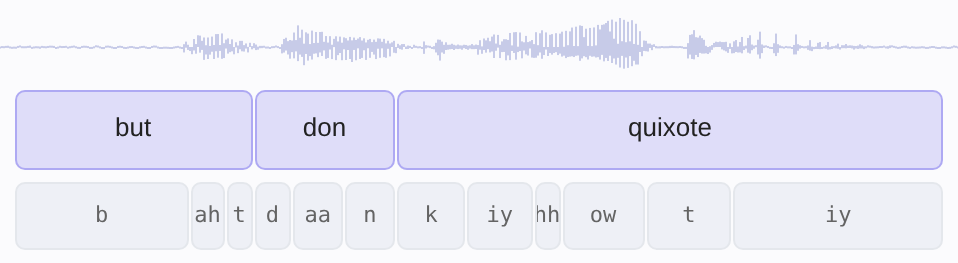
停頓恢復到接近真實的長度。 在 1.1.3 版之前,停頓前的詞會延伸進停頓裡。在我們對 Buckeye 的測試中,中位數約為 80 到 90 ms。因此,回傳的停頓比實際更短。現在,這個詞會在它的聲音結束處結束,中位數誤差在幾毫秒以內。字幕和配音都在停頓處切分語音,所以這一點對它們很重要。
每個結果都帶有停頓和片語。 從 API v1.1.0 起,每個結果多了兩個清單。pauses 列出所有不被任何詞涵蓋、長度在 0.05 秒以上的片段。phrases 在每個 0.1 秒以上的停頓處把詞分開。下面是一段 4.5 秒、共七個詞的片段的結果。
"pauses": [
  {"begin": 0.0, "end": 0.47},
  {"begin": 0.75, "end": 0.84},
  {"begin": 1.132, "end": 1.213},
  {"begin": 1.89, "end": 2.173},
  {"begin": 4.36, "end": 4.48}
],
"phrases": [
  {"begin": 0.47, "end": 1.89, "words": [0, 2]},
  {"begin": 2.173, "end": 4.36, "words": [3, 6]}
]
詞與詞之間有一個停頓達到 0.1 秒以上,所以這段片段分成兩個片語。words 列出每個片語的第一個詞和最後一個詞。
兩種詞邊緣。 從 API v1.2.0 起,你可以選擇詞的計時方式。word_edges=phonetic 是預設值,邊緣放在語音學家標註的位置。word_edges=audible 讓每個詞在你聽到它的地方開始和結束。這時,p、t、k、b、d 或 g 之前的靜音會留在詞的外面,這正是配音和字幕需要的。請在錄音室等級的乾淨錄音上使用 audible 邊緣。
curl https://api.olewave.com/olign/v1 \
  -H "X-API-Key: $OLIGN_KEY" \
  -F [email protected] \
  -F [email protected] \
  -F word_edges=audible
第一個詞與呼吸聲。 第一個詞不會再從它前面的呼吸聲或噪音裡開始。以 p、t、k、b、d 或 g 開頭的第一個詞,最多只保留爆破前 30 ms 的靜音。停頓之後的詞也不會再從它前面的呼吸聲裡開始。
人名和新詞。 從 1.1.0 版起,人名、品牌名和新詞都會取得發音,並依照它們自己的語音進行對齊。以前,這樣的詞回傳時沒有音素,它前後的詞還要承擔它的時間誤差。
長錄音。 錄音最開頭和最結尾的詞不再被截斷或遺失。相鄰的兩個詞也不再重疊。
不需遷移。 API 的變更都是新增內容。在 Olign 1.0 上可用的請求在 Olign 1.1 上同樣可用,表示 audible 邊緣的舊選項名稱也依然有效。
如何解讀這些數字
這些測試只涵蓋英語,包括朗讀語音和對話語音。FA-Bench 是 Olewave 自己的基準,Olign 在其中以未排名的形式列出。評分器已在 GitHub 上公開,任何人都可以取得 TIMIT 和 Buckeye 的授權。你可以把同樣的音訊傳給 Olign,再為回傳的結果評分。