


[Olewave评论] CLIP (3/3): 从自然语言监督学习可转移的视觉模型
CLIP评论的最后一部分聚焦于结果部分,这是OpenAI对比图文模型从有趣想法转变为整个多模态堆栈基础原语的时刻。

[Olewave评论] CLIP (2/3): 从自然语言监督学习可转移的视觉模型
OpenAI的CLIP通过抛弃固定标签集,转而在从互联网上抓取的4亿个(图像、文本)对上进行训练,改变了计算机视觉的游戏规则。


[Olewave长评] Xception: 具有深度可分卷积的深度学习
Xception将Inception假设推向了逻辑极端,通过将跨通道和空间相关性分解为完全独立的操作,而它推广的深度可分卷积现在随处可见


iOS 16 全新听写功能如何工作?一位语音研究员揭秘苹果的秘制配方!
苹果 iOS 16 的听写功能完全在设备本地运行,这一设计选择对延迟、隐私以及手机上可行的 ASR 架构类型产生连锁影响。

[长评论] Conformer: 用于语音识别的卷积增强 Transformer
Conformer 是那个悄悄接管端到端 ASR 的模型,其配方——在每个 Transformer 块上添加卷积模块——被证明是那些看似简单但行之有效的想法之一。

[长评] 级联扩散模型高保真图像生成
在Imagen和DALL-E 2将扩散模型作为生成图像的默认选择之前,这篇Google Brain论文阐述了许多后来的文本到图像系统悄悄借鉴的级联扩散方案:从小

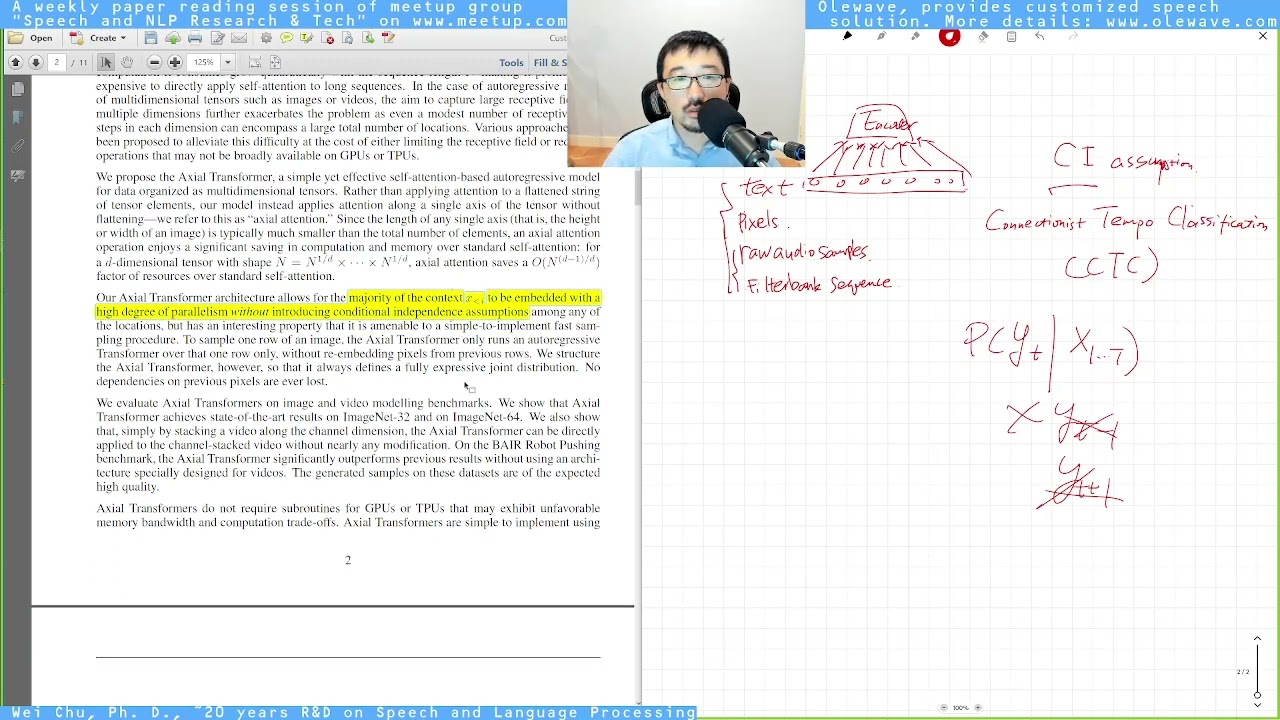
[长评] 多维Transformer中的Axial Attention
对图像或视频进行完整自注意力的计算成本太高,那么你如何在不产生二次计算爆炸的情况下保持Transformer的表达能力呢?
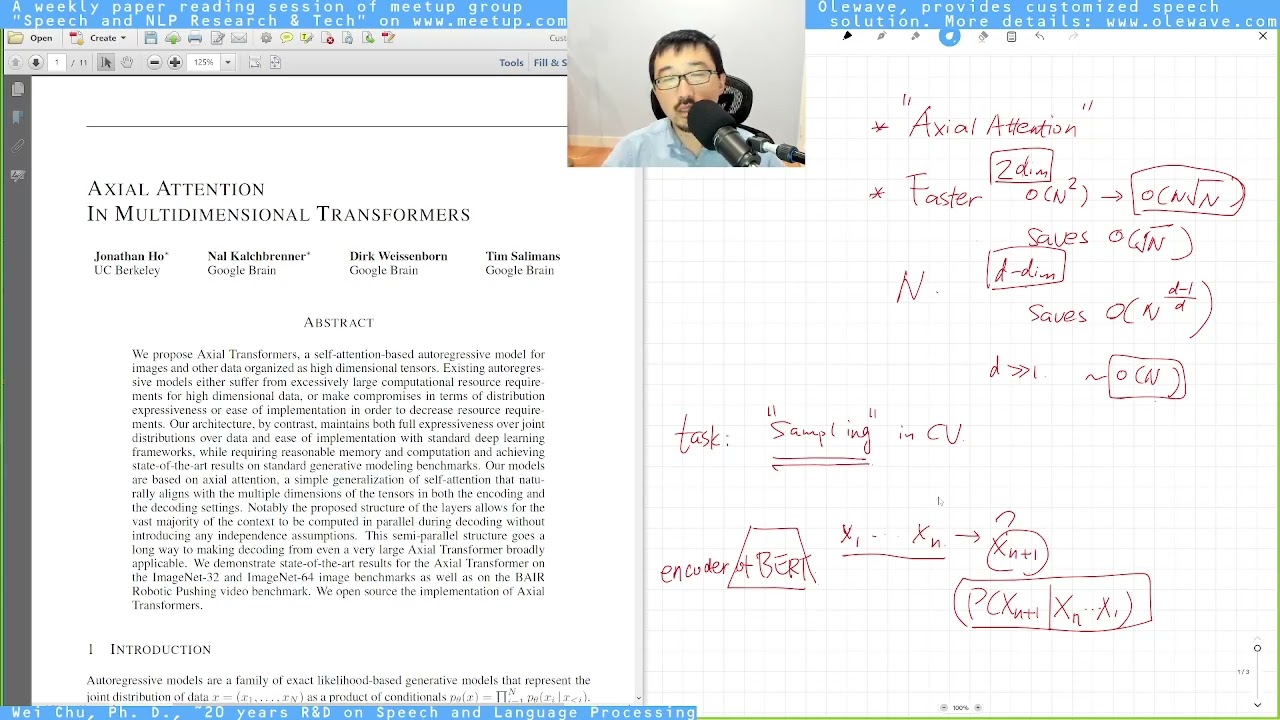
[短评] 多维Transformer中的Axial Attention
Axial Attention是使Transformer在高维数据上保持可处理性的优雅想法之一:你不是一次对所有像素或所有时间-频率箱进行注意力计算,而是一次沿一个轴进行。

[长评] 从说话人验证迁移学习到多说话人Text-To-Speech合成
这是使零样本声音克隆实用化的论文:在具有数千个嘈杂、无转录的声音上训练说话人编码器以进行判别验证任务,然后将这些嵌入馈送到Tacotron 2 s

[短评] 从说话人验证迁移学习到多说话人Text-To-Speech合成
启动现代零样本声音克隆浪潮的Google论文具有美观简洁的架构:基于验证训练的说话人编码器、将文本加说话人嵌入转化的Tacotron 2合成器

[短评] Wav2Seq:使用伪语言预训练语音到文本编码器-解码器模型
像wav2vec 2.0这样的自监督预训练给了我们很好的语音编码器,但如果您想要一个完整的编码器-解码器ASR系统,解码器仍然从零开始。


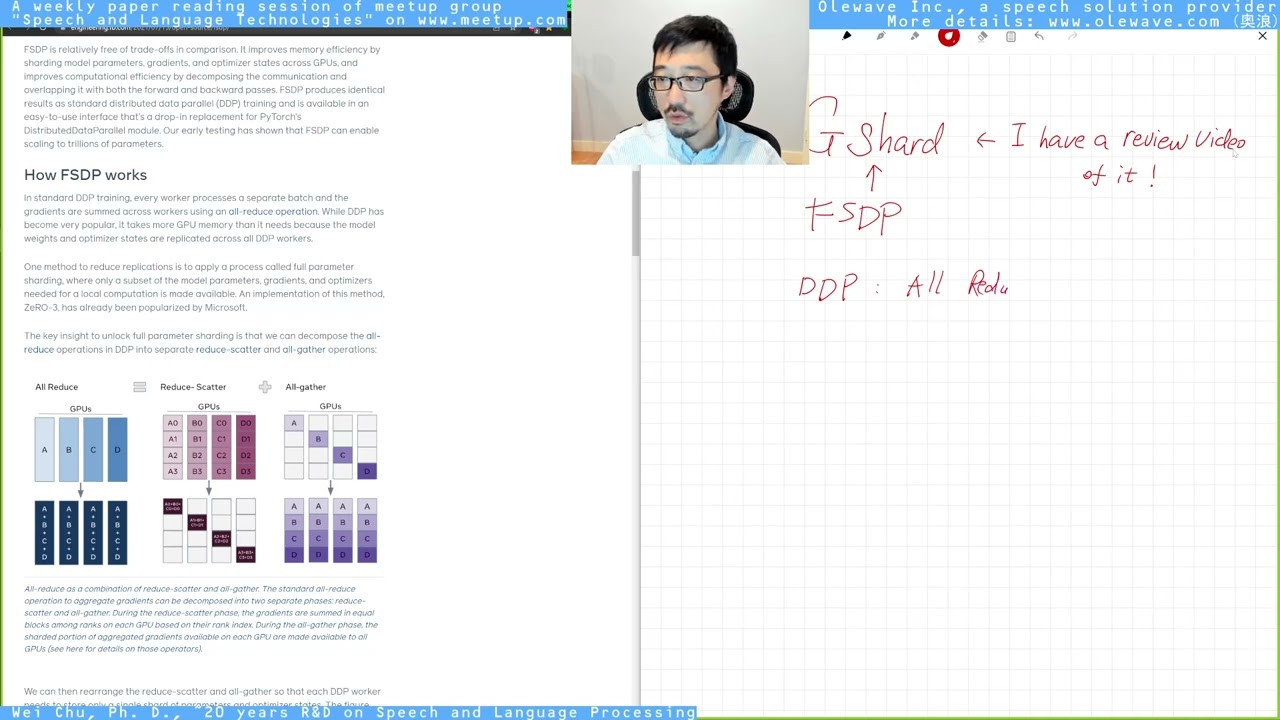
[短评] 完全分片数据并行:用更少的GPU进行更快的AI训练
完全分片数据并行是Meta对每个语音和语言团队最终都会提出的问题的答案:我们如何能够训练大一个数量级的模型,而无需配置大一个数量级的GPU?
