


Olign 1.1 发布,词时间戳更准确
在 FA-Bench 的每个测试集上,无论是干净音频还是噪声环境,Olign 1.1 给出的词时间都比 Olign 1.0 更准确。你现有的请求无需改动即可继续使用。
FA-Bench 排行榜 · github.com/olewave/fa-bench
Olign 1.1 已在 Olign API 上线。在我们测量的每个测试集上,无论干净还是加噪,它给出的词时间都比 Olign 1.0 更准确。
词的时间一旦不准,人们马上就能察觉。字幕应在说话人开口时出现,在说完时消失。配音会在停顿处把语音切分成一句句台词,所以每个停顿都必须落在它真实的位置上。语言学习应用应当在每个词被读出的那一刻点亮它。这些都取决于百分之几秒的差别。
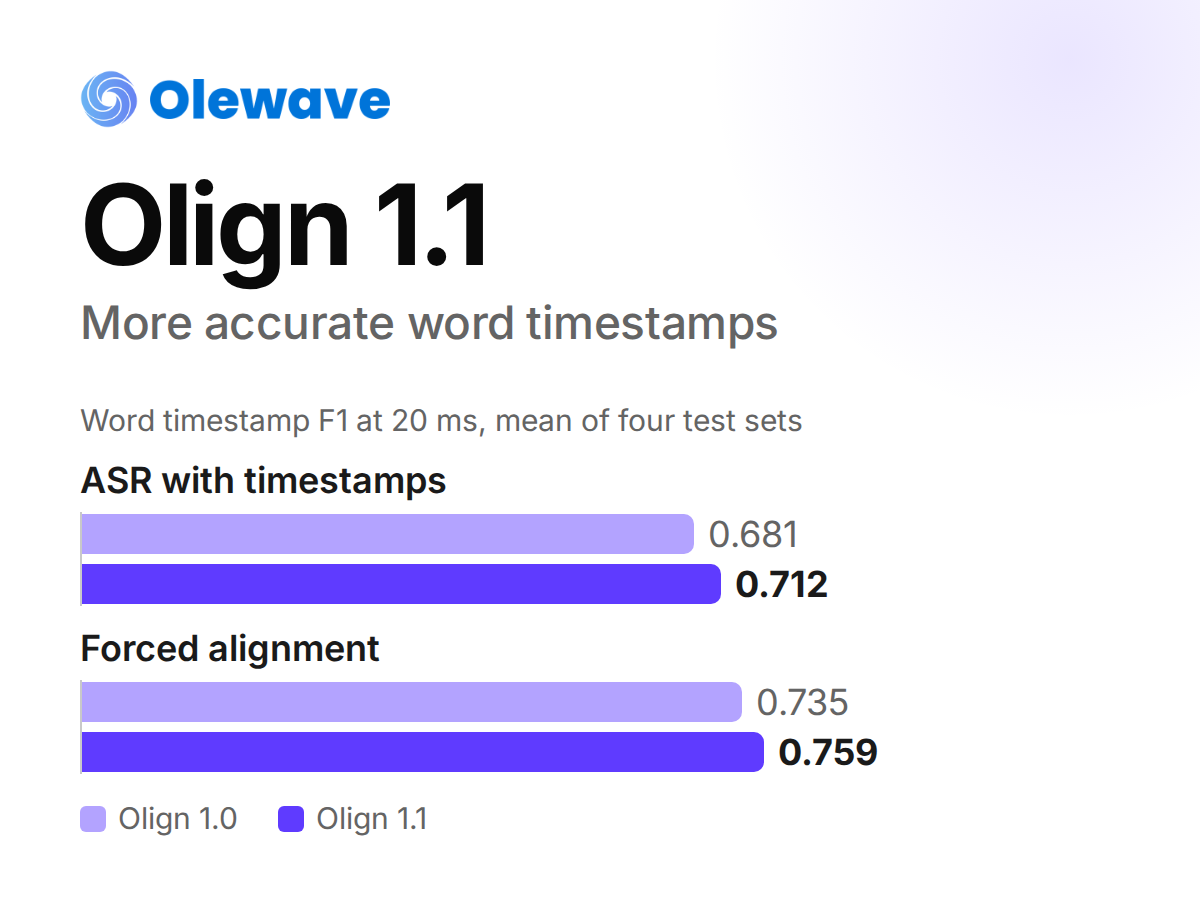
Olign 1.1 让词的时间更贴近语音本身,停顿现在也会以接近真实长度的形式返回。按 FA-Bench 四个测试集的平均值,20 ms 词时间戳 F1 在只有音频时从 0.681 提升到 0.712,在附带文本稿时从 0.735 提升到 0.759。你现有的请求无需改动即可继续使用。
测量方法
我们比较了 2026 年 11 月在线上服务中测量的 Olign 1.1.3 版本,以及 2026 年 10 月测量的 Olign 1.0。两者在相同的测试集上运行,并由同一个公开的 FA-Bench 评分器打分。
FA-Bench 使用两个英语语料库,它们的词边界和音素边界都由人工标注。TIMIT core test 是朗读语音,Buckeye test 是对话语音。每个语料库都会以干净音频运行,也会分别加入混响、噪声、音乐和多人交谈声后运行。下文的“加噪”是这四种情况的平均值。这样一共是四个测试集,“四项平均”就是它们的平均值。
测试分两个赛道。带时间戳的 ASR 只拿到音频,Olign 返回自己识别出的词和它们的时间。强制对齐还会拿到文本稿。
20 ms 词时间戳 F1 衡量词的起始时间和结束时间中,有多大比例落在人工标注的 20 ms 以内,它综合了精确率和召回率。越高越好。
词错误率 统计被替换、漏掉或多出的词,并以它们占实际所说词数的比例表示。越低越好。
词边界误差 是 Olign 的词边界与人工标注边界之间的平均距离,单位为毫秒。越低越好。
20 ms 音素边界 F1 与词时间戳 F1 是同一个指标,只是用在音与音之间的边界上。
Olewave 同时开发了 FA-Bench 和 Olign。因此,Olign 在 FA-Bench 排行榜上以未排名的形式列在表格底部。本文把 FA-Bench 当作一把公开、可复现的尺子来使用,不做任何排名。
带时间戳的 ASR
你只发送音频。
词时间戳 F1 在全部四个测试集上都有提升。提升最大的是干净的 Buckeye,从 0.660 升到 0.702。词错误率几乎没有变化,平均从 7.5% 变为 7.4%。所以提升来自时间的准确度。
全部数字
| TIMIT 干净 | TIMIT 加噪 | Buckeye 干净 | Buckeye 加噪 | 四项平均 | |
|---|---|---|---|---|---|
| 词时间戳 F1,Olign 1.0 | 0.786 | 0.695 | 0.660 | 0.585 | 0.681 |
| 词时间戳 F1,Olign 1.1 | 0.804 | 0.726 | 0.702 | 0.615 | 0.712 |
| 词错误率,Olign 1.0 | 2.2% | 3.2% | 10.2% | 14.3% | 7.5% |
| 词错误率,Olign 1.1 | 2.2% | 3.2% | 9.9% | 14.2% | 7.4% |
强制对齐
你发送音频和对应的文本稿。
词时间戳 F1 在全部四个测试集上都有提升,词边界误差在四个测试集上都有下降。词边界误差下降最多的是加噪的 TIMIT,从 33.0 ms 降到 25.7 ms。音素边界 F1 在各处都略有提升,平均从 0.452 升到 0.458。大部分变化发生在词的边缘。
全部数字
| TIMIT 干净 | TIMIT 加噪 | Buckeye 干净 | Buckeye 加噪 | 四项平均 | |
|---|---|---|---|---|---|
| 词时间戳 F1,Olign 1.0 | 0.805 | 0.710 | 0.755 | 0.668 | 0.735 |
| 词时间戳 F1,Olign 1.1 | 0.824 | 0.747 | 0.775 | 0.689 | 0.759 |
| 词边界误差,Olign 1.0 | 18.2 ms | 33.0 ms | 22.4 ms | 43.8 ms | |
| 词边界误差,Olign 1.1 | 17.0 ms | 25.7 ms | 18.7 ms | 38.8 ms | |
| 音素边界 F1,Olign 1.0 | 0.410 | 0.393 | 0.523 | 0.483 | 0.452 |
| 音素边界 F1,Olign 1.1 | 0.413 | 0.396 | 0.529 | 0.492 | 0.458 |
有哪些变化
Olign 的发布版本和 API 各有自己的版本号。下文会分别注明。
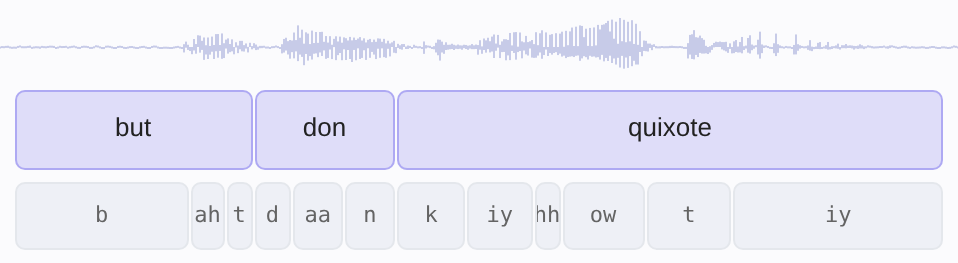
停顿恢复到接近真实的长度。 在 1.1.3 版之前,停顿前的词会延伸进停顿里。在我们对 Buckeye 的测试中,中位数约为 80 到 90 ms。因此,返回的停顿比实际更短。现在,这个词会在它的声音结束处结束,中位数误差在几毫秒以内。字幕和配音都在停顿处切分语音,所以这一点对它们很重要。
每个结果都带有停顿和短语。 从 API v1.1.0 起,每个结果多了两个列表。pauses 列出所有不被任何词覆盖、长度在 0.05 秒及以上的片段。phrases 在每个 0.1 秒及以上的停顿处把词分开。下面是一段 4.5 秒、共七个词的片段的结果。
"pauses": [
  {"begin": 0.0, "end": 0.47},
  {"begin": 0.75, "end": 0.84},
  {"begin": 1.132, "end": 1.213},
  {"begin": 1.89, "end": 2.173},
  {"begin": 4.36, "end": 4.48}
],
"phrases": [
  {"begin": 0.47, "end": 1.89, "words": [0, 2]},
  {"begin": 2.173, "end": 4.36, "words": [3, 6]}
]
词与词之间有一个停顿达到 0.1 秒及以上,所以这段片段分成两个短语。words 给出每个短语的第一个词和最后一个词。
两种词边缘。 从 API v1.2.0 起,你可以选择词的计时方式。word_edges=phonetic 是默认值,边缘放在语音学家标注的位置。word_edges=audible 让每个词在你听到它的地方开始和结束。这时,p、t、k、b、d 或 g 之前的静音会留在词的外面,这正是配音和字幕所需要的。请在录音棚级别的干净录音上使用 audible 边缘。
curl https://api.olewave.com/olign/v1 \
  -H "X-API-Key: $OLIGN_KEY" \
  -F [email protected] \
  -F [email protected] \
  -F word_edges=audible
第一个词与呼吸声。 第一个词不会再从它前面的呼吸声或噪声里开始。以 p、t、k、b、d 或 g 开头的第一个词,最多只保留爆破之前 30 ms 的静音。停顿之后的词也不会再从它前面的呼吸声里开始。
人名和新词。 从 1.1.0 版起,人名、品牌名和新词都会获得发音,并按照它们自己的语音进行对齐。以前,这样的词返回时没有音素,它前后的词还要承担它的时间误差。
长录音。 录音最开头和最结尾的词不再被截断或丢失。相邻的两个词也不再重叠。
无需迁移。 API 的改动都是新增内容。在 Olign 1.0 上可用的请求在 Olign 1.1 上同样可用,表示 audible 边缘的旧选项名也依然有效。
如何解读这些数字
这些测试只涵盖英语,包括朗读语音和对话语音。FA-Bench 是 Olewave 自己的基准,Olign 在其中以未排名的形式列出。评分器已在 GitHub 上公开,任何人都可以获得 TIMIT 和 Buckeye 的授权。你可以把同样的音频发给 Olign,再为返回的结果打分。