


Olign 1.1 登場、単語タイムスタンプがより正確に
Olign 1.1 は FA-Bench のすべてのテストセットで、クリーンな音声でもノイズの中でも、Olign 1.0 より正確に単語の時刻を求めます。今お使いのリクエストはそのまま動きます。
FA-Benchリーダーボード · github.com/olewave/fa-bench
Olign 1.1 を Olign API で公開しました。測定したすべてのテストセットで、クリーンな音声でもノイズのある音声でも、Olign 1.0 より正確に単語の時刻を求めます。
単語のタイミングのずれは、見る人や聞く人にすぐ伝わります。字幕は話し始めに表示され、話し終わりに消えるべきです。吹き替えではポーズで音声をセリフに分けるため、ポーズは実際の位置にある必要があります。語学アプリは、各単語が読み上げられるその瞬間に光らせるべきです。どれも 100 分の数秒の違いで決まります。
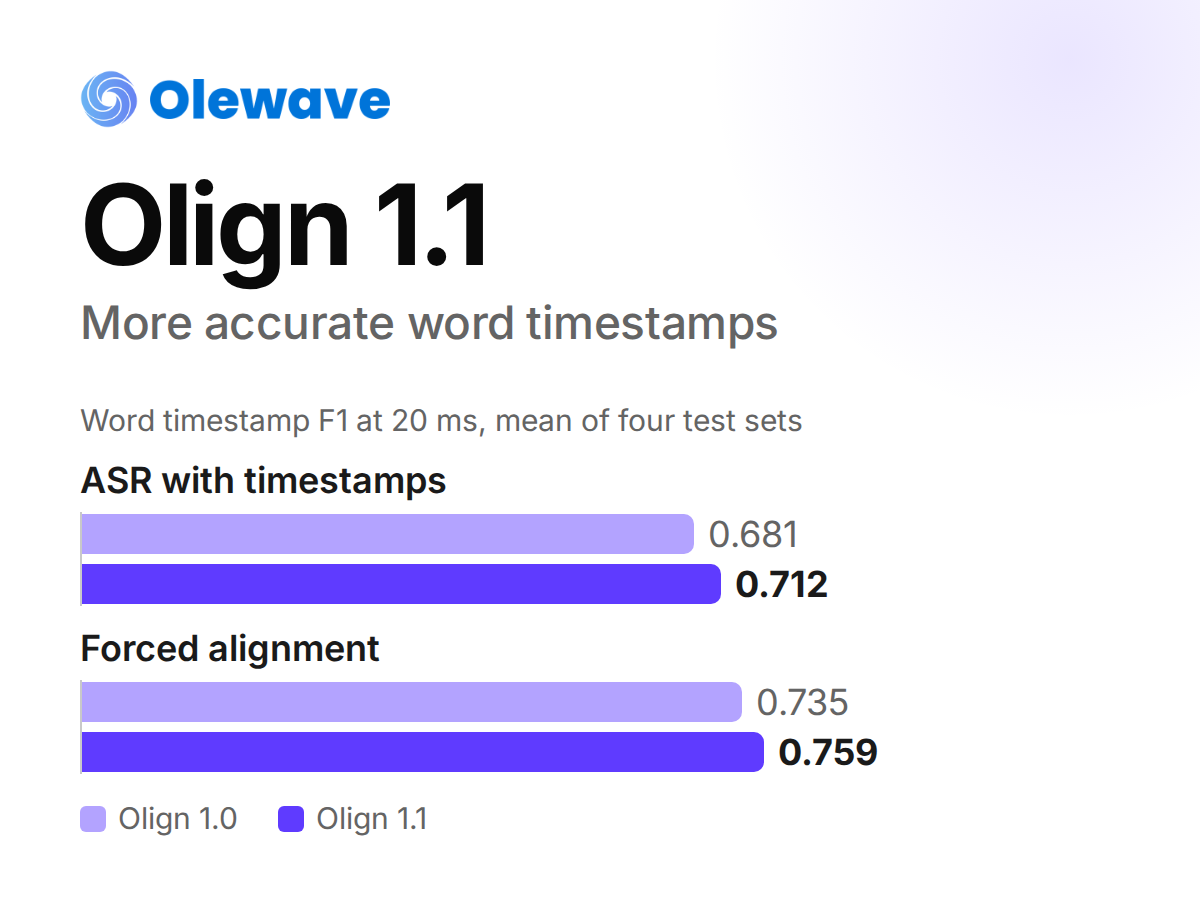
Olign 1.1 は単語の時刻を実際の音声に近づけ、ポーズも実際の長さに近い形で返すようになりました。FA-Bench の4つのテストセットの平均で、20 ms での単語タイムスタンプ F1 は、音声だけの場合に 0.681 から 0.712 へ、書き起こし付きの場合に 0.735 から 0.759 へ上がりました。今お使いのリクエストはそのまま動きます。
測定方法
2026年11月に本番サービスで測定した Olign リリース 1.1.3 と、2026年10月に測定した Olign 1.0 を比べました。どちらも同じテストセットで実行し、同じ公開の FA-Bench スコアラーで採点しています。
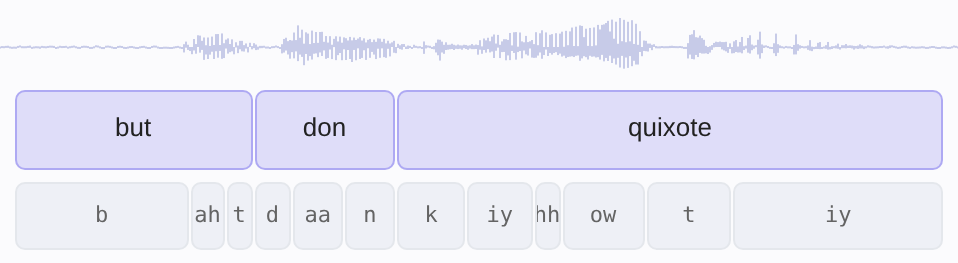
FA-Bench は、単語と音素の境界を人手でラベル付けした2つの英語コーパスを使います。TIMIT core test は読み上げ音声、Buckeye test は会話音声です。どちらもクリーンな音声と、残響、雑音、音楽、バブルノイズを加えた音声で実行します。以下の「ノイズ」はその4種類の平均です。これで4つのテストセットになり、「4つの平均」はその平均値です。
トラックは2つあります。タイムスタンプ付き ASR は音声だけを受け取り、Olign が自ら認識した単語を時刻付きで返します。強制アライメントは書き起こしも受け取ります。
20 ms での単語タイムスタンプ F1 は、単語の開始時刻と終了時刻のうち、人手のラベルから 20 ms 以内に収まるものの割合を、適合率と再現率を合わせて表したものです。高いほど良い値です。
単語誤り率 は、置き換えられた単語、抜けた単語、余分に加わった単語を数え、話された単語数に対する割合で表します。低いほど良い値です。
単語境界誤差 は、Olign の単語境界と人手でラベル付けした境界との平均距離を、ミリ秒で表したものです。低いほど良い値です。
20 ms での音素境界 F1 は、単語タイムスタンプ F1 と同じ指標を、音と音の境界に当てはめたものです。
Olewave は FA-Bench と Olign の両方を開発しています。そのため、Olign は FA-Bench のリーダーボードで順位なしとして表の最下部に掲載されています。この記事では FA-Bench を、公開され再現できる物差しとして使っています。順位付けは一切していません。
タイムスタンプ付き ASR
音声だけを送ります。
単語タイムスタンプ F1 は4つのテストセットすべてで上がりました。最も大きく伸びたのはクリーンな Buckeye で、0.660 から 0.702 です。単語誤り率はほとんど変わらず、平均で 7.5% から 7.4% です。つまり、伸びたのはタイミングです。
すべての数値
| TIMIT クリーン | TIMIT ノイズ | Buckeye クリーン | Buckeye ノイズ | 4つの平均 | |
|---|---|---|---|---|---|
| 単語タイムスタンプ F1、Olign 1.0 | 0.786 | 0.695 | 0.660 | 0.585 | 0.681 |
| 単語タイムスタンプ F1、Olign 1.1 | 0.804 | 0.726 | 0.702 | 0.615 | 0.712 |
| 単語誤り率、Olign 1.0 | 2.2% | 3.2% | 10.2% | 14.3% | 7.5% |
| 単語誤り率、Olign 1.1 | 2.2% | 3.2% | 9.9% | 14.2% | 7.4% |
強制アライメント
音声とその書き起こしを送ります。
単語タイムスタンプ F1 は4つのテストセットすべてで上がり、単語境界誤差は4つすべてで下がりました。単語境界誤差が最も大きく下がったのはノイズのある TIMIT で、33.0 ms から 25.7 ms です。音素境界 F1 はどこでもわずかに上がり、平均で 0.452 から 0.458 です。変化の大部分は単語の端で起きています。
すべての数値
| TIMIT クリーン | TIMIT ノイズ | Buckeye クリーン | Buckeye ノイズ | 4つの平均 | |
|---|---|---|---|---|---|
| 単語タイムスタンプ F1、Olign 1.0 | 0.805 | 0.710 | 0.755 | 0.668 | 0.735 |
| 単語タイムスタンプ F1、Olign 1.1 | 0.824 | 0.747 | 0.775 | 0.689 | 0.759 |
| 単語境界誤差、Olign 1.0 | 18.2 ms | 33.0 ms | 22.4 ms | 43.8 ms | |
| 単語境界誤差、Olign 1.1 | 17.0 ms | 25.7 ms | 18.7 ms | 38.8 ms | |
| 音素境界 F1、Olign 1.0 | 0.410 | 0.393 | 0.523 | 0.483 | 0.452 |
| 音素境界 F1、Olign 1.1 | 0.413 | 0.396 | 0.529 | 0.492 | 0.458 |
変わったこと
Olign のリリースと API には、それぞれ別のバージョン番号があります。以下では両方を記します。
ポーズが実際の長さに近くなりました。 リリース 1.1.3 より前は、ポーズの前の単語がポーズに食い込んでいました。Buckeye でのテストでは、その幅は中央値でおよそ 80 から 90 ms でした。そのため、ポーズは実際より短く返っていました。今は単語が音の終わりで終わり、中央値は数ミリ秒以内です。字幕と吹き替えはポーズで音声を区切るため、ここで効いてきます。
すべての結果にポーズとフレーズ。 API v1.1.0 から、各結果にリストが2つ加わりました。pauses には、どの単語にも含まれない 0.05 秒以上の区間がすべて入ります。phrases は、0.1 秒以上のポーズごとに単語を区切ります。7単語、4.5秒のクリップでは次のようになります。
"pauses": [
  {"begin": 0.0, "end": 0.47},
  {"begin": 0.75, "end": 0.84},
  {"begin": 1.132, "end": 1.213},
  {"begin": 1.89, "end": 2.173},
  {"begin": 4.36, "end": 4.48}
],
"phrases": [
  {"begin": 0.47, "end": 1.89, "words": [0, 2]},
  {"begin": 2.173, "end": 4.36, "words": [3, 6]}
]
単語の間のポーズのうち 0.1 秒以上のものが1つあるため、このクリップは2つのフレーズになります。words は各フレーズの最初と最後の単語を示します。
2種類の単語の端。 API v1.2.0 から、単語の時刻の付け方を選べます。word_edges=phonetic が既定で、音声学者が境界を置く位置に端を置きます。word_edges=audible は、各単語を耳に聞こえる位置で始めて終えます。このとき p、t、k、b、d、g の前の無音は単語の外に残ります。吹き替えや字幕に必要な形です。audible の端は、スタジオ品質のクリーンな録音で使ってください。
curl https://api.olewave.com/olign/v1 \
  -H "X-API-Key: $OLIGN_KEY" \
  -F [email protected] \
  -F [email protected] \
  -F word_edges=audible
最初の単語と息継ぎ。 最初の単語が、その前の息や雑音の中から始まることはなくなりました。p、t、k、b、d、g で始まる最初の単語は、破裂の前の無音を最大 30 ms までしか含みません。ポーズの後の単語も、その前の息継ぎの中から始まることはなくなりました。
人名と新しい語。 リリース 1.1.0 から、人名、ブランド名、新しい語にも発音が付き、その語自身の音に合わせてアライメントされます。以前はこうした語が音素なしで返り、前後の単語がそのタイミングの誤りを引き受けていました。
長い録音。 録音のいちばん最初と最後の単語が、切れたり抜けたりしなくなりました。隣り合う2つの単語が重なることもなくなりました。
移行作業は不要です。 API の変更は追加のみです。Olign 1.0 で動いていたリクエストは Olign 1.1 でも動きます。audible の端を指定する古いオプション名も引き続き使えます。
この数値の読み方
テストは英語のみで、読み上げ音声と会話音声が対象です。FA-Bench は Olewave 自身のベンチマークで、Olign はそこに順位なしで掲載されています。スコアラーは GitHub で公開されており、TIMIT と Buckeye は誰でもライセンスを取得できます。同じ音声を Olign に送り、返ってきた結果を採点してみてください。