من Whisper OpenAI إلى خدمة ASR الخاصة بك: التعرف على الكيانات الاسمية والمصطلحات الخاصة بالمجال
Whisper خارج الصندوق مثير للإعجاب، لكن أي شخص قام فعلاً بنشره في الإنتاج يعرف الألم: فهو يخطئ في الأسماء الصحيحة، وأسماء المنتجات، والمصطلحات الطبية، والمصطلحات…
Olewave في ICASSP 2024
كنا رعاة وعارضين في IEEE ICASSP 2024 في سيول، وألقى مؤسسنا والمدير التنفيذي Wei Chu محادثة بارزة عن تدريب نماذج الكلام من البيانات البرية المأخوذة من الويب.

محلل التشفير المتغير (VAE) وخدعة إعادة المعاملة - إعادة النظر في نموذج التوليد الكلاسيكي
قبل الانتشار، قبل تدفقات التطبيع، قبل نماذج الانتشار الكامنة التي بنت بهدوء ترميزات VAE في كل مكدس توليدي جدير بالاهتمام — كانت هناك ورقة Kingma و Welling لعام…
مراجعة نماذج الكلام الكبيرة مفتوحة المصدر من Microsoft+OpenAI و Google و Meta و Nvidia لـ ASR
لقد قامت كل مختبر ذكاء اصطناعي رئيسي الآن بشحن نموذج كلام كبير مفتوح المصدر لـ ASR، وأصبح اختيار النموذج الصحيح للإنتاج قراراً حقيقياً.

Tycho: أداة لبناء خدمات الكلام الخاص عالية ROI (ASR/TTS/Translation): نظرة عامة
معظم الفرق التي تريد خدمة ASR أو TTS أو ترجمة كلام الخاص تواجه نفس الاختيار الفوضوي: لصق أجزاء من ESPnet و NeMo و k2 و HuggingFace معاً، أو تسليم كل شيء إلى واج…

من نموذج OpenAI Whisper إلى خدمة ASR الخاصة بك: المعالجة اللاحقة والنمذجة اللغوية
مخرجات Whisper الخام مثيرة للإعجاب خارج الصندوق، لكن أي شخص قام بنشرها لدى مستخدمين حقيقيين يعرف الفجوة بين نسخة توضيحية وشيء يمكن لنظام المعالجة اللاحقة أن يس…

من نموذج OpenAI Whisper إلى خدمة ASR الخاصة بك: الصوت الطويل والبث المباشر (الجزء 3)
تم تدريب Whisper على أجزاء مدتها 30 ثانية، وهذا يظهر عندما تطعمه بودكاست لمدة ساعتين أو تحاول ربطه بخط أنابيب الترجمة المباشرة.
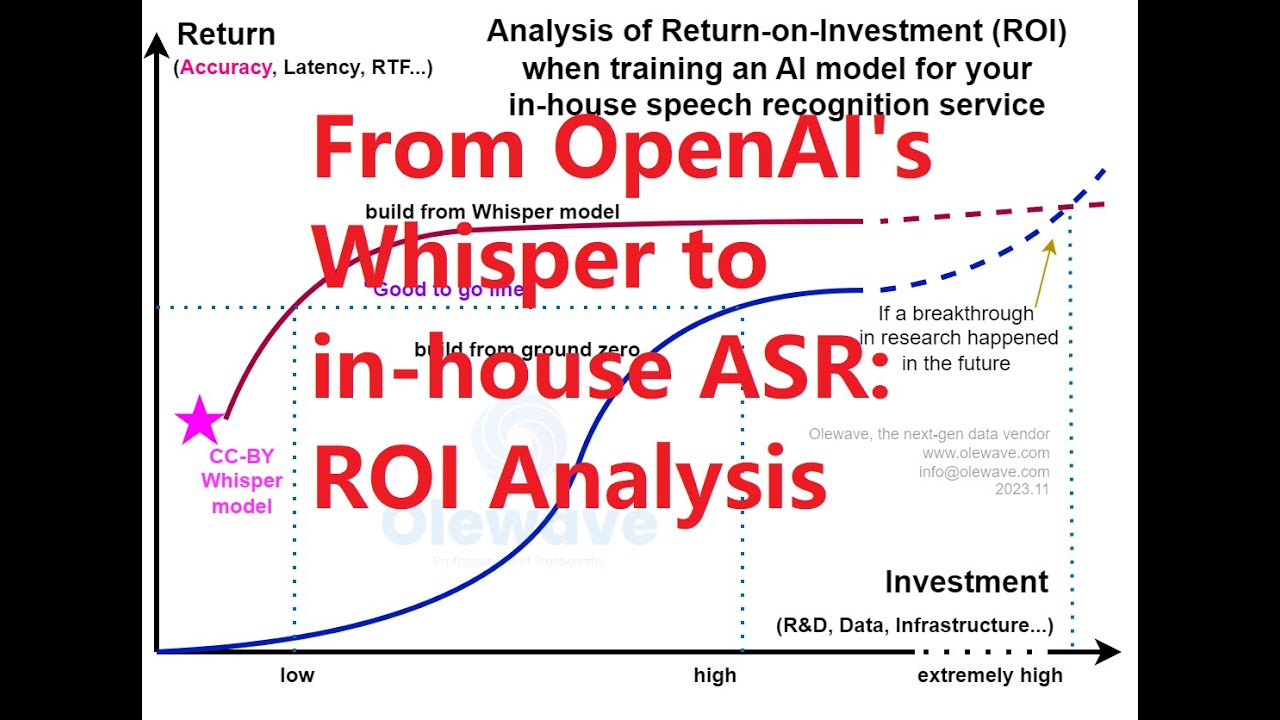
من نموذج OpenAI Whisper إلى خدمة ASR الخاصة بك: العائد على الاستثمار (الجزء 2)
عادة ما يتم طرح سؤال البناء مقابل الشراء بخصوص ASR كمسألة دقة مقابل الراحة، لكن العامل الحقيقي المحدد هو العائد على الاستثمار على مدى عمر المنتج.
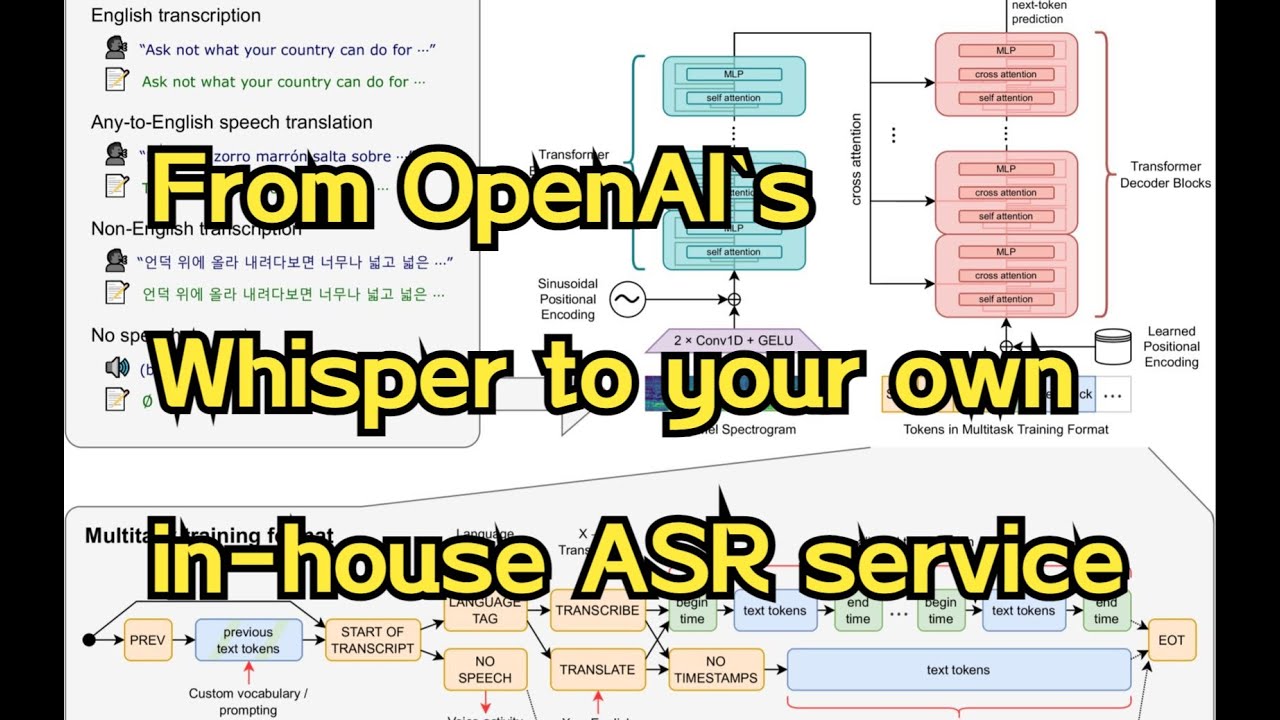
من نموذج OpenAI Whisper إلى خدمة ASR الخاصة بك: نظرة عامة (الجزء 1)
عندما فتحت OpenAI مصدر Whisper، أعادت بهدوء تعيين خط الأساس لما تبدو عليه خدمة ASR الخاصة.

لماذا الطوابع الزمنية للكلمات التي ينتجها OpenAI Whisper غير دقيقة؟ كيف تجعلها دقيقة مرة أخرى؟
اطلب من Whisper طوابع زمنية للكلمات وستحصل على أرقام — لكن إذا حاولت يومًا ما محاذاتها مع الصوت الفعلي للكاريوكي أو الترجمة أو المزامنة، ستعرف أنها تنجرف وتنجذب…

الذكاء الاصطناعي التوليدي للكلام: VoiceBox من Meta AI (أيضًا Flow Matching و Neural ODE)
لسنوات عديدة، تخلف توليد الكلام عن توليد النص والصور من حيث النطاق والعمومية — حصلت كل مهمة على نموذج مخصص بها.
I-JEPA: نموذج العالم الأول من Yann LeCun لرؤية الحاسوب
Yann LeCun جادل لسنوات بأن الاستدراج التوليدي هو الرهان الخاطئ لبناء آلات تفهم العالم.

LoRA: السماح لطالب في المدرسة الثانوية بتدريب نموذج اللغة الكبيرة (GPT-3) بطاقة رسومات ألعاب
الضبط الدقيق الكامل لـ GPT-3 بـ 175 مليار معامل هو نقطة عدم البدء لجميع الناس تقريبًا — التخزين وحده يستبعده، ناهيك عن بطاقات الرسومات.

مراجعة SpeechT5: إدخال T5 من Google إلى مهام الكلام (ASR, TTS, SID, ...)
وحّد T5 مهام النص إلى النص تحت وصفة تدريب مسبق واحدة للمشفر-فك الشفرة وأصبح حصان العمل في NLP.

مراجعة HiFi-GAN: الشبكات العدائية التوليدية لتوليف الكلام الفعال والعالي الدقة
لفترة طويلة، فرضت المحللات الصوتية العصبية عليك الاختيار بين جانبين: أعطتك نماذج الانحدار الذاتي مثل WaveNet صوتًا جميلًا لكنه بطيء بشكل مؤلم، بينما كانت مولدات …

مراجعة متعمقة لـ SoundStream من Google: أكوديك صوتي عصبي من النهاية إلى النهاية
أصبحت الأكوديكات العصبية بهدوء الطبقة الأساسية للصوت التوليدي الحديث، و SoundStream هي إحدى الأوراق الرائدة في هذا المجال.
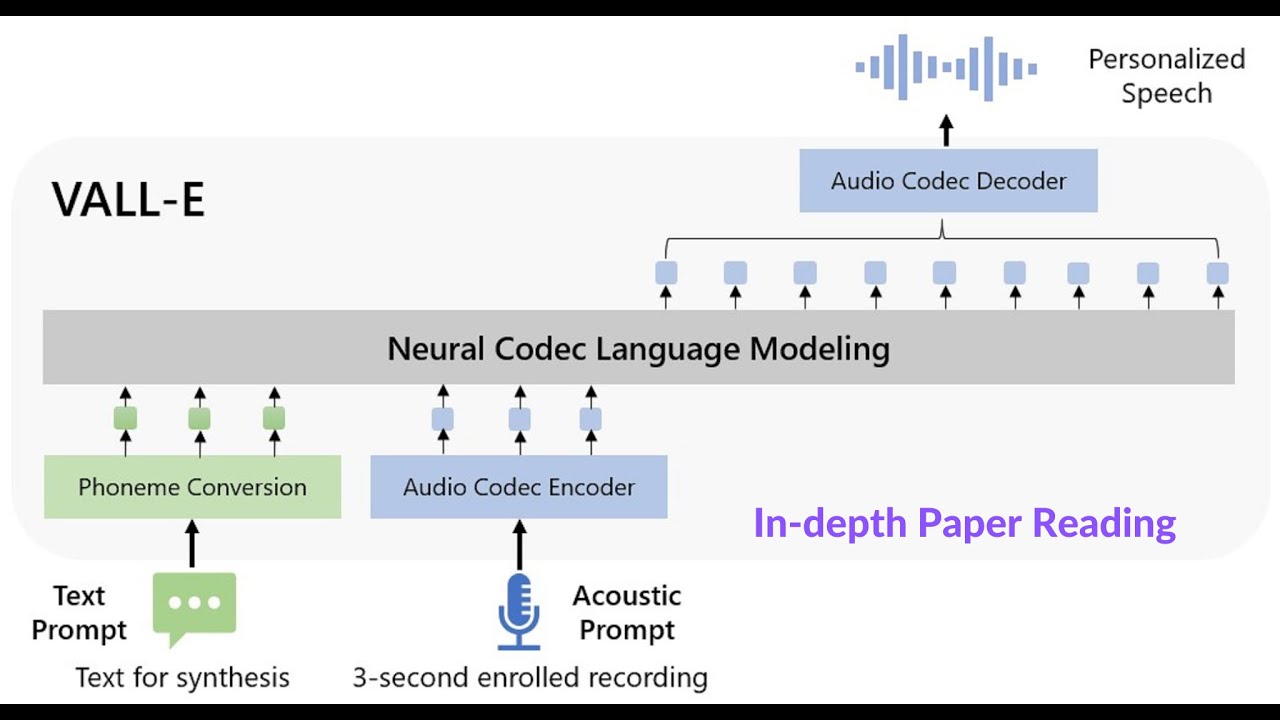
مراجعة متعمقة لـ VALL-E: نماذج ترميز اللغة العصبية هي مركبات نص إلى كلام بدون عينة
بدت فكرة نقل TTS بدون عينة من مقطع مرجعي مدته ثلاث ثواني بعيدة المنال حتى وصلت VALL-E، وتفكك هذه المراجعة المتعمقة بالضبط كيفية تحقيق Microsoft لذلك.

إضافة عدم التصادم في الأخطاء اللفظية (NCMA) للتعرف على الكلام باللهجة
كلام بلهجة والكلام غير الأصلي يكسران قاموس النطق بطرق تسمم بهدوء محاذاة نموذجك الصوتي، وهذا البحث من Interspeech 2021 يطرح سؤالاً بسيطاً ظاهرياً: ماذا لو أضفنا فقط
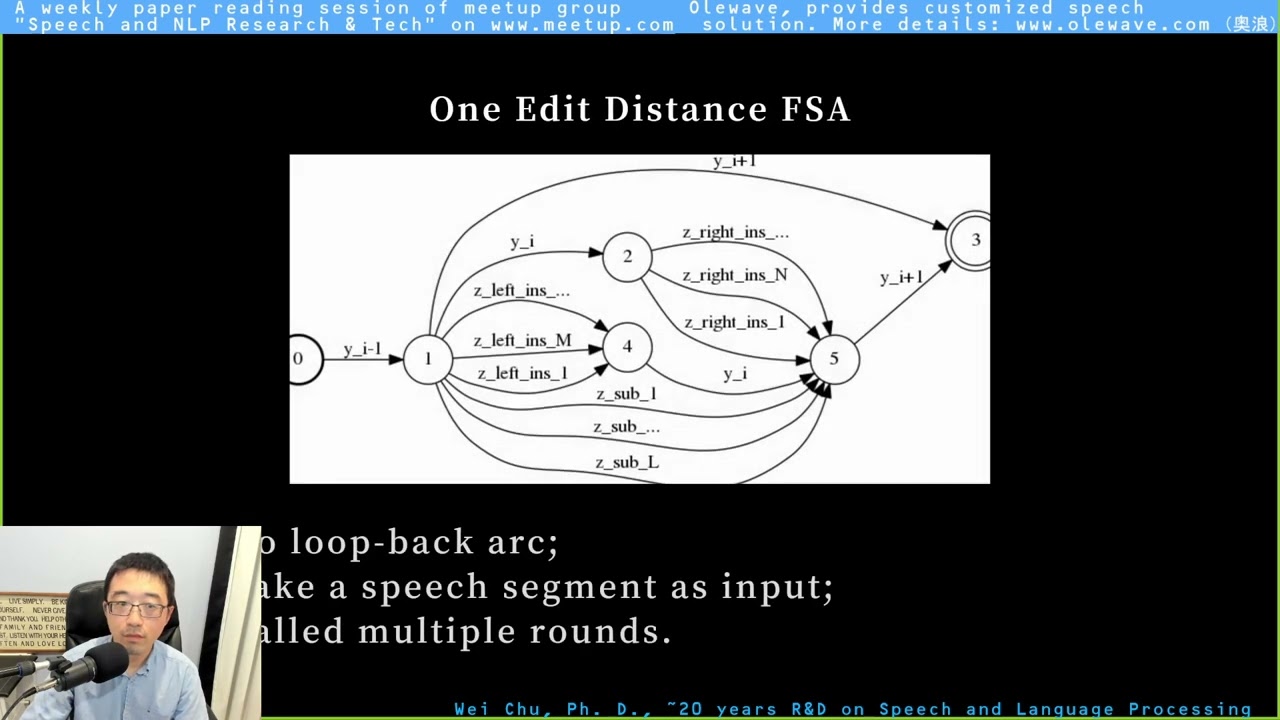
واحد-تحرير-مسافة FSA/Network-based (OEDN) في كشف الأخطاء اللفظية والتعرف على الكلام باللهجة
تحتوي النمذجة الصوتية غير الأصلية على مشكلة الدجاجة والبيضة: محاذاات الهاتف السيئة تنتج نماذج سيئة، والنماذج السيئة تنتج محاذاات سيئة.

[Olewave's Short Review] Xception: التعلم العميق مع Depthwise Separable Convolutions
إذا كنت تريد فكرة Xception الأساسية فقط بدون الغوص العميق الطويل، فهذه المراجعة القصيرة هي النسخة السريعة.

[مراجعة قصيرة] Conformer: Transformer معزز بالالتفاف للتعرف على الكلام
استحوذ Conformer على عالم ASR بقوة عاصفة بفعل شيء بسيط تقريباً: إضافة وحدة التفاف إلى كل كتلة Transformer بحيث يلتقط النموذج السياق العام والتفاصيل الصوتية المح…

博士大叔使用计算机作弊降维打击2022高考数学压轴大题 Ph.D. يستخدم الحاسوب للغش في حل امتحان رياضيات gaokao 2022
ماذا يحدث عندما تطلق مجموعة أدوات جبر حاسوبية من مستوى البحث على أصعب مسألة في امتحان gaokao للرياضيات 2022؟

[مراجعة طويلة] Wav2Seq: نماذج مشفر-فاك مدرب مسبقاً للكلام إلى نص باستخدام لغات وهمية
ركزت معظم طرق التدريب المسبق للكلام على جانب المشفر، wav2vec و HuBERT و WavLM، لكن ASR من تسلسل إلى تسلسل يحتاج أيضاً إلى فاك مدرب مسبقاً.

[Short Review] نحو التعلم اللغوي بدون تسميات
ماذا لو أن البيانات المسماة التي قضيت أشهراً في شرحها لم تكن ضرورية على الإطلاق؟

[مراجعة طويلة] إلغاء تكرار بيانات التدريب يجعل نماذج اللغة أفضل
يبدو إلغاء التكرار ممل حتى تتعلم أن جملة واحدة من 61 كلمة تظهر أكثر من 60,000 مرة داخل C4، وأن نماذج اللغة المدربة على مثل هذه المجموعات تعيد نص بيانات التدريب…

متزلجو الأرقام الروسيون مثل التوائم الثلاثية: هل يمكن استخدام Kullback-Leibler Divergence لتمييز الفرق بينهم؟
تكييف المتحدث هو أحد تلك مشاكل ASR التي تبدو محلولة حتى تحاول فعلاً تكييف نموذج sequence-to-sequence دون تدمير التمثيلات الصوتية الصعبة المكتسبة للمشفر.
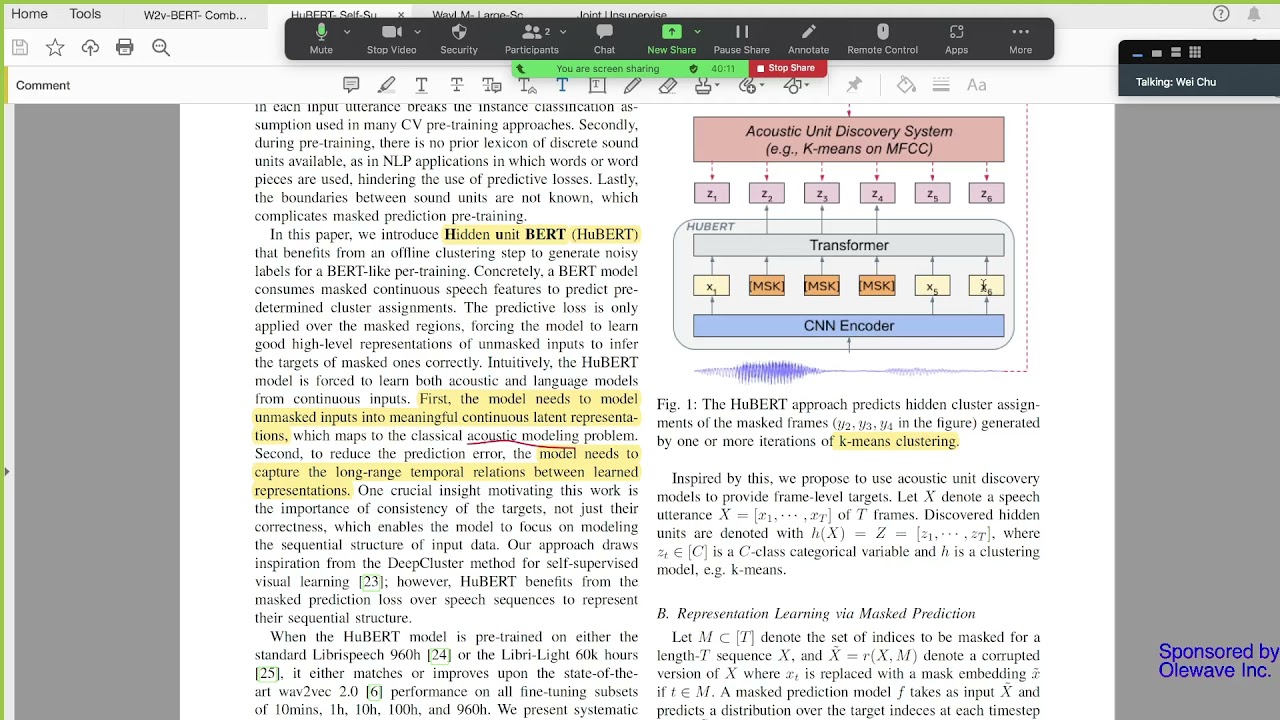
HuBERT: تعلم التمثيل الكلامي ذاتي الإشراف من خلال التنبؤ المقنع بالوحدات المخفية
غيّرت wav2vec 2.0 قواعد اللعبة بالإشراف الذاتي التباعدي، لكن HuBERT طرح سؤالاً أكثر حدة: ماذا لو تجاوزنا خدعة التباعد كلياً وقمنا فقط بالتنبؤ المقنع على غرار BERT…
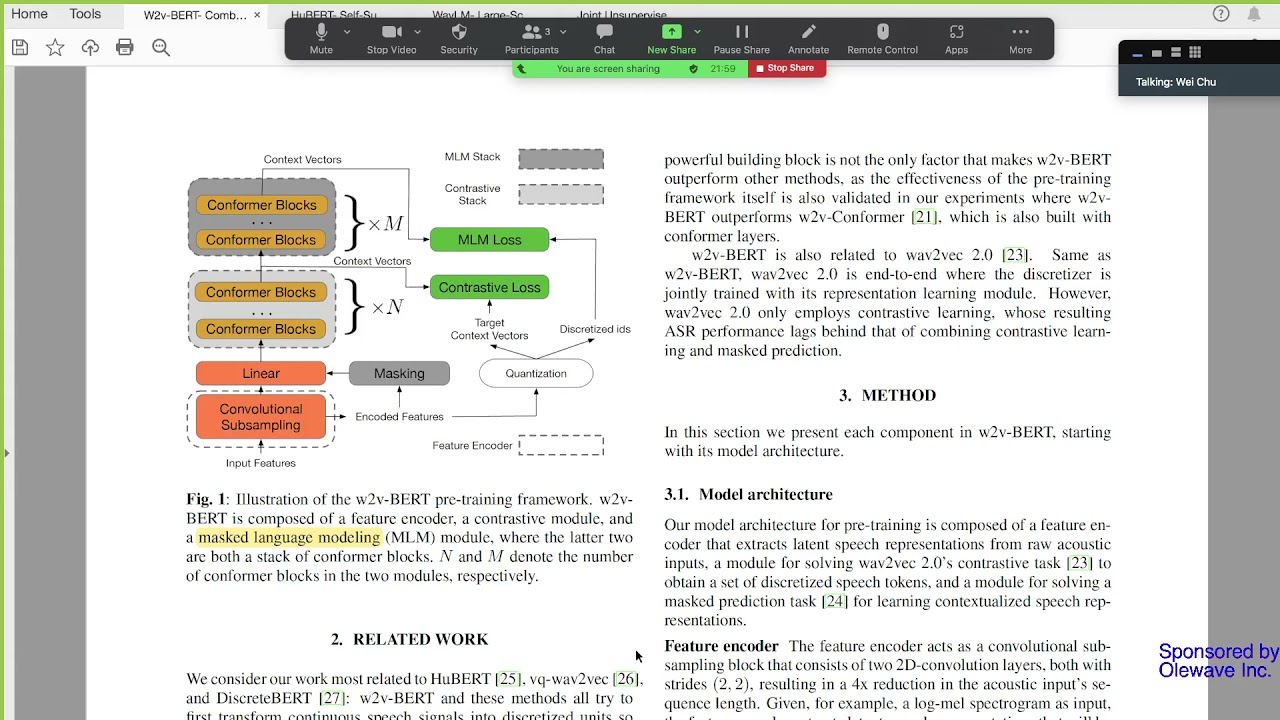
W2v-BERT: دمج التعلم التباعدي والنمذجة اللغوية المقنعة للإشراف الذاتي
لماذا تختار بين التعلم التباعدي والنمذجة اللغوية المقنعة للتدريب المسبق للكلام عندما يمكنك ربط كليهما في نفس الشبكة؟

استكشاف ضبط Wav2vec 2.0 الدقيق لتحسين التعرف على المشاعر الكلامية
لطالما كان التعرف على المشاعر الكلامية عالقاً مع مجموعات بيانات صغيرة مُحددة والميزات الصوتية المصنوعة يدويّاً.
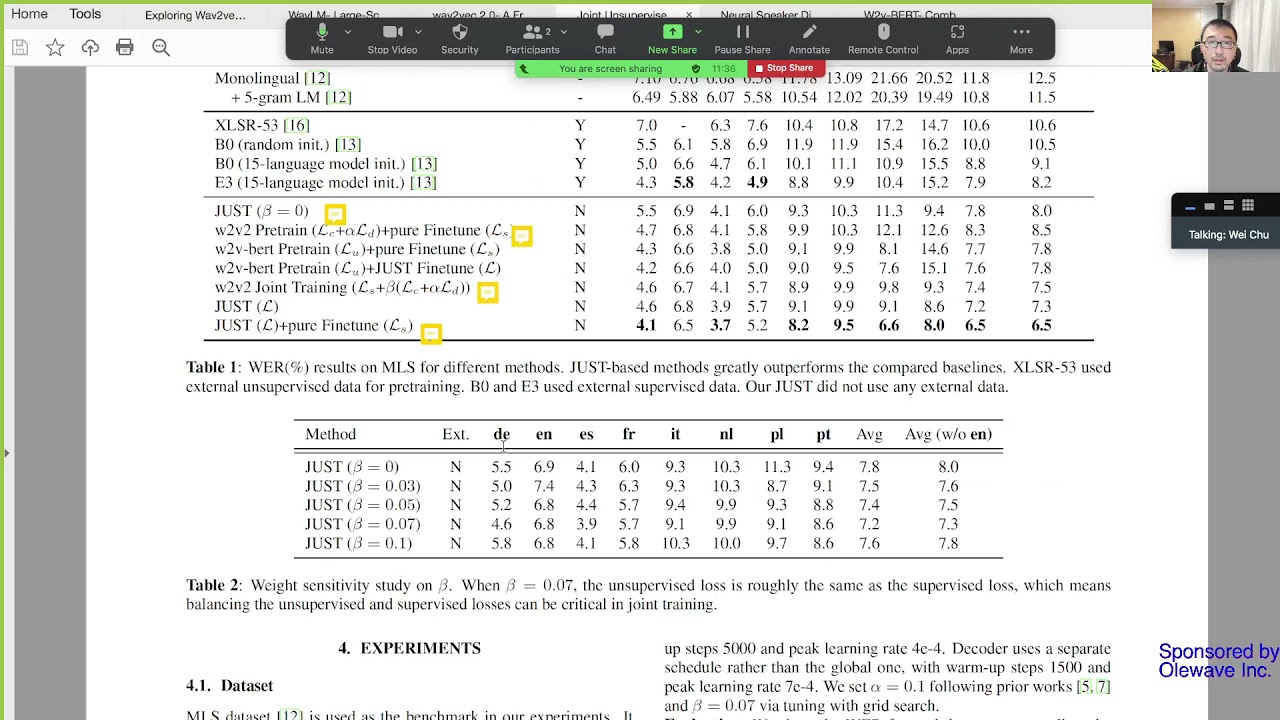
التدريب المشترك بدون إشراف وبإشراف للتعرف التلقائي على الكلام متعدد اللغات
أصبح التدريب المسبق ثم الضبط الدقيق هو الوصفة الافتراضية للتعرف التلقائي على الكلام متعدد اللغات، لكنه يترك الكثير على الطاولة: المرحلتان لا تتشاركان الخسائر، …